I risultati che collegano le classi
Teoremi del corso
Leggi l'enunciato, poi apri la scheda: trovi l'idea, la frase da scrivere nella risposta e la dimostrazione.
I 17 teoremi segnati con ★ servono in almeno 8 domande delle tracce ciascuno e da soli coprono circa due terzi delle citazioni: parti da quelli. Ordina per «Più chiesti» per vederli per primi.
Capitolo 1 · Macchina di Turing
proposizioneProposizione 2.1 (ricorsivo ⇒ ricorsivamente enumerabile)
per l'oraledimostrato nel corsoSe un linguaggio è ricorsivo (esiste una MdT che lo decide), allora è anche ricorsivamente enumerabile (esiste una MdT che lo accetta): .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione 2.1 (ricorsivo ⇒ ricorsivamente enumerabile)
Intuizione
Si prende la macchina che decide e, invece di fermarsi in "no", la si fa andare a destra all'infinito.
All'esame
Giustifica quando si colloca un problema nella scala R, RE, coRE.
Da scrivere all'esame
SÌ: ogni linguaggio ricorsivo è ricorsivamente enumerabile (), perché dalla MdT che lo decide se ne ottiene una che lo accetta trasformando il "no" in un ciclo infinito.
Dimostrazione
Idea: dalla macchina che decide costruiamo una macchina che si limita ad accettarlo. Basta trasformare ogni risposta "no" in un ciclo infinito.
- Per ipotesi è ricorsivo: esiste una MdT che su ogni input si ferma, nello stato "yes" se ( appartiene a ) e nello stato "no" se ( non appartiene a ).
- Costruiamo (si legge "emme primo") che si comporta esattamente come , con una sola modifica: ogni volta che sta per entrare nello stato "no", entra invece in uno stato nuovo in cui sposta il cursore a destra per sempre, senza mai fermarsi. Cambiano solo le transizioni che portano in "no", quindi è ancora una MdT.
- Se , arriva in "yes". fa le stesse mosse di (la modifica non entra mai in gioco), quindi arriva anch'essa in "yes": .
- Se , arriverebbe in "no". Proprio in quel punto comincia a muoversi a destra all'infinito, quindi (la computazione non termina).
- I punti 3 e 4 dicono esattamente che accetta : "yes" sugli elementi di , nessuna risposta sugli altri. Quindi è ricorsivamente enumerabile.
Siccome era un linguaggio ricorsivo qualsiasi, vale .
Dove: dispensa cap. 1, p. 7; slide Lez. 2. Le slide della Lez. 5 richiamano anche che i ricorsivi e i ricorsivamente enumerabili sono separati per diagonalizzazione (dal corso di Elementi di Informatica Teorica): l'inclusione stretta non è dimostrata in questo corso.
Capitolo 2 · MdT multinastro
teoremaTeorema dello speedup multinastro (da nastri a 1)
chiesto in 5 domandedimostrato nel corsoPer ogni MdT a nastri che lavora in tempo esiste una MdT a un solo nastro che lavora in tempo e dà lo stesso risultato: per ogni input .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema dello speedup multinastro (da nastri a 1)
Intuizione
I nastri si concatenano su un solo nastro con dei marcatori per le testine; ogni passo di costa due scansioni di un nastro lungo .
All'esame
Il numero di nastri cambia il tempo al più di un fattore quadratico, quindi P e le classi polinomiali non dipendono dal numero di nastri.
Da scrivere all'esame
Per lo speedup multinastro una MdT a nastri in tempo si simula con un nastro solo in tempo : i nastri cambiano il tempo solo polinomialmente.
Dimostrazione
Idea: scriviamo i nastri di uno dopo l'altro sull'unico nastro di , segnando dove si trovano i cursori. Ogni passo di si simula con due scansioni di questo nastro, che è lungo : quindi passi per ogni passo di e in tutto.
- Codifica. Sia : sono gli stati, l'alfabeto, il programma, lo stato iniziale. L'alfabeto di contiene , una versione "marcata" di ogni simbolo (indica la cella su cui sta un cursore), un simbolo (versione dell'inizio-nastro che si può scavalcare) e un separatore che chiude ciascun nastro. Una configurazione di con nastri diventa la stringa , dove in ogni l'ultimo simbolo (quello sotto il cursore) è marcato. Il doppio finale segna la fine del nastro di .
- Inizio. sposta l'input di una cella a destra, scrive davanti e aggiunge in fondo i nastri vuoti. Servono pochi stati in più, in numero che dipende solo da e , non dall'input.
- Prima scansione (lettura). scorre il nastro da sinistra a destra e raccoglie i simboli marcati, cioè i simboli letti dai cursori di . Li "ricorda" nello stato: ha uno stato per ogni stato di e ogni sequenza di al più simboli. Sono in numero finito perché , e sono fissati.
- Seconda scansione (scrittura). Ora conosce e i simboli letti, quindi sa da che cosa farebbe . Scorre di nuovo il nastro e, a ogni simbolo marcato, scrive il nuovo simbolo e sposta la marcatura nella cella vicina, nella direzione indicata da .
- Caso speciale. Se un cursore di deve andare a destra oltre la fine del suo nastro (cioè su un ), serve una cella nuova: sposta di una posizione a destra tutto ciò che segue e scrive un blank al posto del vecchio .
- Fine. Quando si ferma, cancella i nastri simulati tranne l'ultimo, che contiene l'output, e lo riporta nel formato normale. Quindi .
- Tempo. fa al più passi, cioè sta nel budget di tempo , e a ogni passo un nastro cresce al più di una cella: ogni nastro è lungo al più , e il nastro di al più . Simulare un passo costa una scansione avanti e indietro per leggere, più una scansione per ciascuno dei nastri da modificare (spostamenti compresi): passi. Per passi di il totale è , perché è una costante che dipende da e non dall'input.
Dove serve nelle tracce
G16 n. 5 · G20v4 n. 5 · MA23 n. 4 · LU24 n. 3 · SP n. 2
Classi
Dove: dispensa cap. 2, p. 13; slide Lez. 2
teoremaTeorema 2.5 (le RAM si simulano con le MdT)
Se una RAM calcola una funzione in tempo , esiste una MdT a 7 nastri che calcola in tempo .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 2.5 (le RAM si simulano con le MdT)
Intuizione
Un modello molto vicino ai calcolatori reali risolve gli stessi problemi delle MdT, con una perdita di efficienza solo polinomiale.
All'esame
Giustifica l'uso delle MdT come modello: un problema in tempo polinomiale su RAM resta in P.
Da scrivere all'esame
Per il Teorema 2.5 una RAM in tempo si simula con una MdT in tempo : ciò che è polinomiale su RAM resta in P.
Schema della dimostrazione
Idea: i registri della RAM si scrivono su un nastro come coppie (indirizzo, contenuto) in binario, e ogni istruzione della RAM si simula scorrendo questo nastro. Il punto chiave è che i numeri nei registri non possono crescere troppo in fretta, quindi il nastro resta corto.
- La RAM. Ha un programma finito di istruzioni (lettura dell'input, LOAD, STORE, ADD, SUB, HALF, salti condizionati, HALT) che lavorano su registri contenenti interi grandi a piacere. Non c'è la moltiplicazione: le operazioni aritmetiche sono somma, sottrazione e dimezzamento.
- Lemma sulla lunghezza dei numeri. Dopo passi ogni registro contiene un intero lungo in binario al più , dove è la lunghezza dell'input e la lunghezza della costante più grande del programma. Perché: una somma o una sottrazione allunga un numero al più di un bit, il dimezzamento lo accorcia, e un caricamento copia un numero che c'era già. Quindi a ogni passo la lunghezza massima cresce al più di 1.
- La MdT. Il primo nastro contiene l'input. Il secondo contiene i registri usati, come sequenza di coppie "indirizzo : contenuto" in binario. L'istruzione corrente si ricorda negli stati, perché il programma è finito. Gli altri nastri tengono l'indirizzo del registro cercato e servono da appoggio per fare somme, sottrazioni e dimezzamenti in binario, come su carta. In tutto bastano 7 nastri.
- Costo di un'istruzione. In passi la RAM scrive al più registri diversi (uno per passo), e per il punto 2 ogni indirizzo e ogni contenuto è lungo (l'input e le costanti si contano nel budget). Quindi il nastro dei registri è lungo . Cercare un registro, leggerlo, fare l'operazione e riscrivere il risultato richiede un numero costante di scansioni di questo nastro: passi.
- Totale. istruzioni, ciascuna simulata in passi: tempo . La MdT calcola la stessa funzione (fi) perché esegue le stesse istruzioni sugli stessi valori.
Il corso enuncia il teorema senza prova (Teorema 2.5 del Papadimitriou); qui ne è dato lo schema.
Classi
Dove: slide Lez. 2. Solo nelle slide della Lez. 2 (Teorema 2.5 del Papadimitriou); la dispensa non lo riporta.
teoremaTeorema dello speedup lineare
per l'oraledimostrato nel corsoSe , allora per ogni vale .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema dello speedup lineare
Intuizione
Raggruppando più simboli in uno solo la macchina fa più lavoro a ogni passo: le costanti moltiplicative si possono sempre eliminare.
All'esame
Spiega perché conta solo la notazione : per esempio, se allora .
Da scrivere all'esame
Per lo speedup lineare, se allora per ogni : le costanti moltiplicative del budget non contano, conta solo l'.
Dimostrazione
Idea: usa un solo simbolo per rappresentare un blocco di simboli di (come allungare la "parola" di un processore). Così simula passi di con al più 6 passi propri; scegliendo abbastanza grande rispetto a (epsilon) il tempo scende sotto , più il tempo lineare per comprimere l'input.
- Macchina di partenza. Sia una MdT a nastri che decide entro il budget di tempo , e sia . ha nastri (2 se ) e alfabeto : oltre ai simboli di , tutte le -uple di simboli. L'intero dipende solo da e lo fissiamo alla fine. Alfabeto e programma di diventano enormi, ma restano finiti.
- Compressione dell'input. scorre l'input ricordando nello stato i simboli già letti del blocco corrente; ogni simboli scrive sul secondo nastro il singolo simbolo , completando l'ultimo blocco con dei . Questo costa passi. Da qui in poi il secondo nastro fa la parte del nastro di input di , e tutti i nastri contengono solo blocchi.
- Rappresentazione. Se è nello stato e il suo cursore -esimo è nella cella numero , allora è nello stato , cioè ricorda dove si trova ogni cursore dentro il suo blocco, e il cursore -esimo di sta sul blocco che contiene la cella . Questi stati sono , un numero finito.
- Una fase: lettura. Su ogni nastro fa un passo a sinistra, due a destra e uno a sinistra (4 passi), memorizzando nello stato anche i blocchi a sinistra e a destra del cursore. Ora conosce i simboli di intorno a ciascun cursore.
- Una fase: scrittura. In passi un cursore di si sposta al più di celle, quindi non esce da questi simboli. Allora l'effetto dei prossimi passi di è già determinato da ciò che ha nello stato, e il programma di è costruito per applicarlo direttamente: cambiano solo il blocco centrale e uno dei due vicini, e bastano 2 passi. Se si ferma durante questi passi, si ferma con la stessa risposta. Quindi decide .
- Conto. usa passi per la compressione e poi al più 6 passi per ogni gruppo di passi di : in tutto circa . Scegliendo (il più piccolo intero ) si ha , quindi lavora in tempo .
Dove: dispensa cap. 2, p. 14; slide Lez. 2. La dispensa enuncia il teorema senza prova; le slide della Lez. 2 lo dimostrano.
proposizioneProposizione (MdT con input e output)
per l'oraledimostrato nel corsoPer ogni MdT a nastri che lavora in tempo esiste una MdT con input e output a nastri che dà lo stesso output e lavora in tempo .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (MdT con input e output)
Intuizione
Si copia l'input sul secondo nastro, si simula sui nastri centrali e alla fine si copia l'output sull'ultimo nastro.
All'esame
Il nastro di input in sola lettura non toglie potenza: per questo lo spazio si misura senza contare input e output, e si possono definire L e NL.
Da scrivere all'esame
Ogni MdT a nastri in tempo si simula con una MdT con input e output a nastri in tempo : l'input in sola lettura non toglie potenza.
Dimostrazione
Idea: copia l'input su un nastro di lavoro e da lì in poi lascia il primo nastro solo in lettura; simula sui nastri centrali e alla fine copia il risultato sull'ultimo nastro scrivendo solo verso destra. Ogni fase costa .
- Vincoli da rispettare. Una MdT con input e output deve avere: (a) il primo nastro mai modificato (sola lettura); (b) sull'ultimo nastro il cursore mai verso sinistra (sola scrittura); (c) il cursore dell'input mai oltre il primo dopo l'input.
- Fase 1: copia dell'input. scorre il primo nastro e copia sul secondo nastro: passi, con . Il primo nastro viene solo letto e il cursore si ferma al primo , quindi (a) e (c) valgono; dopo questa fase il primo nastro non si usa più.
- Fase 2: simulazione. riporta il cursore del secondo nastro all'inizio e simula usando i nastri al posto dei nastri di : ogni passo di diventa un passo di . Il primo e l'ultimo nastro non vengono toccati. Costo: al più passi, perché rispetta il budget di tempo .
- Fase 3: copia dell'output. Quando si ferma, il suo output sta sul suo ultimo nastro, cioè sul nastro di . lo copia sul nastro muovendo quel cursore solo verso destra, quindi (b) vale. In passi non può scrivere più di celle, quindi questa copia costa passi.
- Correttezza e tempo. finisce nello stesso stato di ("yes", "no" o ) e con lo stesso output. Il tempo totale è , perché un budget di tempo è sempre almeno (la macchina deve poter leggere l'input).
Dove: dispensa cap. 2, p. 16; slide Lez. 2
teoremaTeorema di compressione dello spazio
chiesto in 4 domandeSe , allora per ogni vale .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema di compressione dello spazio
Intuizione
Come per lo speedup lineare, più celle si codificano in un solo simbolo: le costanti non contano nemmeno per lo spazio.
All'esame
Le costanti moltiplicative non contano nemmeno nelle classi di spazio.
Da scrivere all'esame
Per il teorema di compressione dello spazio, implica per ogni : anche nel budget di spazio le costanti moltiplicative non contano.
Schema della dimostrazione
Idea: come nello speedup lineare, si codificano celle dei nastri di lavoro in un solo simbolo, così lo spazio occupato si divide per . Qui non serve comprimere l'input, perché il nastro di input non si conta nello spazio.
- Partenza. Sia una MdT con input e output che decide entro il budget di spazio , e sia . Scegliamo un intero . Per semplicità consideriamo un solo nastro di lavoro; con più nastri si ripete lo stesso trucco su ciascuno.
- Nuovo alfabeto. ha gli stessi nastri di . Sul nastro di input lavora esattamente come . Sul nastro di lavoro usa l'alfabeto : ogni cella di contiene un blocco di celle consecutive di .
- Stati. Lo stato di ricorda lo stato di e in quale delle posizioni del blocco corrente si trova il cursore di . Sono in numero finito, perché , e sono fissati.
- Simulazione di un passo. Dallo stato sa quale simbolo del blocco sta leggendo ; riscrive il blocco con quel simbolo cambiato e aggiorna la posizione interna. Sposta il proprio cursore sul blocco vicino solo quando il cursore di esce dal blocco. Quindi fa le stesse mosse di e dà la stessa risposta (qui il tempo non ci interessa).
- Spazio. Il nastro di lavoro di è lungo al più celle. Togliendo la cella iniziale con , che tiene a parte, il resto occupa al più celle di . In tutto al più , perché . Il "" conta la cella di e l'arrotondamento dell'ultimo blocco.
Il corso dice solo "prova simile al linear speedup" (Problema 2.8.14 del Papadimitriou); questo è lo schema standard.
Dove: dispensa cap. 2, p. 16; slide Lez. 2. Le slide dicono solo: prova simile al linear speedup (Problema 2.8.14 del Papadimitriou).
Capitolo 3 · MdT nondeterministiche
proposizioneProposizione
per l'oraledimostrato nel corsoOgni problema che una MdT deterministica risolve in tempo polinomiale sta in NP: .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione
Intuizione
Una MdT deterministica è un caso particolare di MdT nondeterministica, in cui la relazione è una funzione.
All'esame
È il primo anello di ogni catena di inclusioni; il viceversa è la questione aperta .
Da scrivere all'esame
SÌ: , perché una MdT deterministica polinomiale è una MdT nondeterministica (con che è una funzione) che decide lo stesso linguaggio nello stesso tempo.
Dimostrazione
Idea: una MdT deterministica è un caso particolare di MdT nondeterministica, quella in cui in ogni situazione c'è esattamente una mossa possibile.
- Sia : esiste una MdT deterministica che decide entro il budget di tempo , per un fissato.
- Definiamo , dove la relazione (delta maiuscola) contiene, per ogni coppia (stato , simbolo ), solo la mossa prescritta da . è una relazione che per caso è una funzione, quindi è a tutti gli effetti una MdT nondeterministica.
- Su ogni input , ha una sola computazione possibile, perché a ogni passo ha una sola scelta: è identica alla computazione di .
- accetta se e solo se esiste una computazione che termina in "yes". L'unica computazione è quella di , quindi accetta . Dunque decide .
- L'unica computazione di ha la stessa lunghezza di quella di , cioè al più passi. Quindi .
Poiché era un qualsiasi problema di P, vale .
Dove: dispensa cap. 3, p. 18; slide Lez. 3
teoremaTeorema (da nondeterministico a deterministico)
chiesto in 7 domandedimostrato nel corsoSe è deciso da una MdT nondeterministica in tempo , allora è deciso da una MdT deterministica a 3 nastri in tempo , con costante che dipende da . In breve: .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema (da nondeterministico a deterministico)
Intuizione
La macchina deterministica prova una dopo l'altra tutte le sequenze di scelte, che sono al più ( è il grado di nondeterminismo).
All'esame
Dà : togliere il nondeterminismo dal tempo, per quanto si sa oggi, costa un esponenziale.
Da scrivere all'esame
Per il teorema da nondeterministico a deterministico : simulare il nondeterminismo costa un esponenziale, quindi per esempio .
Dimostrazione
Idea: ogni computazione di è individuata dalla sequenza delle scelte fatte a ogni passo. La macchina deterministica prova tutte le sequenze di scelte, dalle più corte alle più lunghe; sono al più circa , e ognuna si controlla in tempo .
- Grado di nondeterminismo. Sia . Per ogni stato e simbolo , l'insieme delle mosse possibili è finito, perché è finita. Sia il massimo numero di mosse possibili, . Se , è già deterministica e non c'è nulla da fare; quindi . Numeriamo le mosse di ogni da 1 a .
- Computazioni come sequenze. Una computazione di passi è determinata da una sequenza di interi tra 1 e : dice quale mossa scegliere al passo .
- La macchina . Ha 3 nastri: il primo con l'input, il secondo con la sequenza corrente, il terzo per simulare . Genera le sequenze in ordine di lunghezza ; passare alla successiva è come aggiungere 1 a un numero in base .
- Prova di una sequenza. simula per passi seguendo le scelte (se una scelta non esiste in quella situazione, scarta la sequenza). Se la simulazione arriva in "yes", anche si ferma in "yes".
- Quando rifiutare. non conosce il budget , quindi non può fermarsi "a ". Usa questa regola: se per una certa lunghezza tutte le sequenze portano a computazioni già ferme (in "no" o in ), nessuna computazione di va oltre, e nessuna ha accettato; allora si ferma in "no". Questo succede al più tardi per , perché tutte le computazioni di si fermano entro passi.
- Correttezza. risponde "yes" se e solo se qualche sequenza di scelte porta in "yes", cioè se e solo se accetta , cioè se e solo se .
- Tempo. Le sequenze lunghe al più sono (somma geometrica). Generarne una e simulare al più passi costa . Il totale è con una costante , per esempio , perché . La costante dipende solo da .
Dove serve nelle tracce
F05 n. 4 · G20v1 n. 5 · G20v2 n. 5 · G20v4 n. 5 · G20v5 n. 5 · LU24 n. 3 · SP n. 3
Dove: dispensa cap. 3, p. 20; slide Lez. 3
proposizioneREACHABILITY in spazio logaritmico nondeterministico
per l'oraledimostrato nel corsoREACHABILITY si decide con una MdT nondeterministica in spazio : .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
REACHABILITY in spazio logaritmico nondeterministico
Intuizione
La macchina ricorda solo il nodo corrente e il prossimo, scelto nondeterministicamente: due numeri tra 1 e , cioè celle.
All'esame
Esempio tipico di problema in NL; è anche il punto di partenza del Teorema di Savitch.
Da scrivere all'esame
SÌ: , perché una MdT nondeterministica indovina il cammino ricordando solo il nodo corrente e il successivo, cioè celle di lavoro.
Dimostrazione
Idea: la macchina "indovina" il cammino un nodo alla volta e ricorda solo il nodo corrente e il prossimo. Sono due numeri tra 1 e , che in binario occupano celle.
- Il problema. L'input è un grafo con nodi dato con la matrice di adiacenza; la domanda è se c'è un cammino dal nodo 1 al nodo . (Se la risposta è subito "yes".)
- La macchina , a 3 nastri. Il primo nastro contiene la matrice ed è in sola lettura. Il secondo contiene il nodo corrente , all'inizio 1. Il terzo contiene il prossimo nodo del cammino.
- Un passo. sceglie nondeterministicamente tra 1 e e lo scrive in binario sul terzo nastro. Poi legge nella matrice il bit in posizione . Se è 0 (non c'è l'arco da a ) si ferma in "no". Se è 1 e si ferma in "yes". Altrimenti copia sul secondo nastro, al posto di , e ripete.
- Se c'è un cammino, accetta. Sia un cammino. La computazione che sceglie proprio trova sempre il bit 1 e arriva in "yes". Per accettare basta una computazione.
- Se accetta, c'è un cammino. Una computazione che arriva in "yes" ha controllato che ogni arco tra due nodi scelti consecutivi esiste davvero, quindi i nodi scelti formano un cammino da 1 a . Se il cammino non esiste, nessuna computazione accetta: decide REACHABILITY.
- Spazio. Il nastro di input non si conta. Il secondo e il terzo nastro contengono sempre un numero tra 1 e in binario, cioè circa celle ciascuno: in tutto. L'input è lungo circa , ma , quindi lo spazio è logaritmico anche rispetto alla lunghezza dell'input.
- Computazioni infinite. Alcune computazioni possono girare per sempre in un ciclo del grafo. La definizione di decisione nondeterministica lo permette. Volendo, si aggiunge un contatore fino a , anch'esso di celle, che fa rifiutare dopo passi: un cammino senza ripetizioni ha meno di archi.
Classi
Problemi
Dove: slide Lez. 3; appunti Lez. 3. Presentato nelle slide della Lez. 3 (algoritmo a 3 nastri); la dispensa non lo enuncia come risultato a sé.
Capitolo 4 · Funzioni di complessità proprie
teoremaGap Theorem (Teorema 7.3)
Esiste una funzione ricorsiva tale che .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Gap Theorem (Teorema 7.3)
Intuizione
Con funzioni "strane" come budget anche un aumento esponenziale delle risorse può non dare problemi nuovi: per questo il corso usa solo funzioni di complessità proprie.
All'esame
Motiva l'ipotesi " propria" nei teoremi di gerarchia.
Da scrivere all'esame
Per il Gap Theorem esiste ricorsiva con : senza l'ipotesi di funzione propria i teoremi di gerarchia non valgono.
Schema della dimostrazione
Idea: costruiamo il budget in modo che, per ogni lunghezza , nessuna delle "prime" macchine si fermi su input lunghi dopo un numero di passi compreso tra e . Allora tutto ciò che si fa entro passi si fa già entro passi.
- Enumerazione. Elenchiamo tutte le MdT:
- Intervalli. Fissato , definiamo e . Gli intervalli sono disgiunti, uno dopo l'altro.
- Un intervallo libero. Consideriamo le macchine su tutti gli input di lunghezza : è un numero finito, diciamo , di computazioni. Una computazione che si ferma lo fa dopo un numero preciso di passi, quindi "cade" in al più un intervallo. Con computazioni e intervalli, almeno un intervallo è libero: nessuna computazione si ferma lì dentro. Poniamo , dove è il primo intervallo libero.
- è ricorsiva. Per controllare se l'intervallo è libero basta simulare ogni computazione per al più passi, un numero finito; provando in ordine si trova il primo libero.
- Il gap. Sia , deciso da una macchina . Per ogni , è tra le macchine considerate per . Su un input lungo si ferma entro passi, ma non dentro , perché quell'intervallo è libero: quindi si ferma in meno di passi.
- Input corti. Restano gli input con : sono un numero finito, e una macchina può dare la risposta su di essi con una tabella scritta negli stati, in pochissimi passi. Quindi . L'altra inclusione, , è ovvia.
La costruita è ricorsiva ma non propria: per questo i teoremi di gerarchia richiedono funzioni proprie. Il corso non dà la prova (e la segna come non richiesta): questo è lo schema del Teorema 7.3 del Papadimitriou.
Dove: slide Lez. 4; appunti Lez. 4. Solo nelle slide della Lez. 4 (Teorema 7.3 del Papadimitriou); gli appunti lo segnano come non chiesto all'esame.
teoremaTeorema delle soluzioni precise
per l'oraledimostrato nel corsoSe decide in tempo o spazio , con propria, allora esiste una MdT precisa che decide in tempo o spazio . Precisa vuol dire che ogni computazione si ferma dopo esattamente passi e i nastri di lavoro hanno lunghezza fissata.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema delle soluzioni precise
Intuizione
Prima si calcola il "metro" lungo con la macchina , poi lo si usa come sveglia (tempo) o come limite di memoria (spazio).
Da scrivere all'esame
Per il teorema delle soluzioni precise, con propria si può supporre che tempo o spazio della MdT dipendano solo da , restando nel budget .
Dimostrazione
Idea: prima calcola, con la macchina della funzione propria, un "metro" di esattamente simboli; poi lo usa come sveglia (budget di tempo) o come recinto di memoria (budget di spazio). Così tempo e spazio di dipendono solo da , cioè è precisa.
- Funzione propria. è non decrescente ed esiste una MdT che, su ogni input , scrive sul suo ultimo nastro esattamente quasi-blank , in tempo e spazio ; passi e spazio di dipendono solo da .
- Prima fase (uguale in tutti i casi). esegue su usando nastri propri. Questa fase è deterministica e la sua durata dipende solo da . Il risultato è il metro di lunghezza .
- Budget di tempo. simula su altri nastri e, dopo ogni passo simulato, sposta di una cella a destra il cursore sul metro. Se si ferma prima della fine del metro, ricorda la risposta e continua a scorrere il metro fino al primo vero blank . Siccome si ferma entro passi, la simulazione arriva sempre in fondo e la risposta è quella di . I passi totali sono quelli di più , più una costante: dipendono solo da , quindi è precisa. Il tempo è , perché un budget di tempo è almeno .
- Budget di spazio. fa una copia del metro per ogni nastro di lavoro di e simula scrivendo sui quasi-blank, che tratta come blank. usa al più celle per nastro, quindi non esce mai dal metro. Alla fine ogni nastro di lavoro è lungo esattamente , perché le celle non usate restano : la lunghezza dipende solo da , quindi è precisa. Lo spazio è per più per i nastri: .
- Caso nondeterministico. Se è nondeterministica, anche la simulazione lo è, ma i ragionamenti dei punti 3 e 4 valgono per ogni computazione: la durata o lo spazio dipendono solo dalla fase deterministica di e dalla lunghezza del metro, uguali per tutte le computazioni.
Dove: dispensa cap. 4, p. 21; slide Lez. 4
teoremaTeorema (terminazione delle MdT space-bounded)
per l'oraledimostrato nel corsoSe decide in spazio , con propria, allora esiste che decide in spazio e tale che ogni sua computazione termina.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema (terminazione delle MdT space-bounded)
Intuizione
Le configurazioni possibili sono al più : se la macchina fa più passi di così è in un ciclo, e la si può fermare in "no".
All'esame
È l'idea dietro e quindi .
Da scrivere all'esame
Per il teorema di terminazione, una MdT con budget di spazio ( propria) si rende sempre terminante: ha al più configurazioni, oltre le quali è in un ciclo.
Dimostrazione
Idea: con un budget di spazio la macchina ha solo un numero finito di configurazioni diverse. Se fa più di passi ne ha ripetuta una, quindi è in un ciclo e la si può fermare in "no". Un contatore fino a sta in celle.
- Contare le configurazioni. Una configurazione è data da stato, contenuto del nastro e posizione del cursore. Come nella dispensa, consideriamo un nastro di lavoro lungo al più : gli stati sono , i contenuti possibili al più , le posizioni del cursore al più . Quindi le configurazioni sono al più . Con più nastri, e con la posizione del cursore di input, si aggiungono fattori dello stesso tipo e il ragionamento non cambia.
- Oltre passi c'è un ciclo. Una computazione di più di passi attraversa più di configurazioni, quindi (principio dei cassetti) ne ripete una. Se è deterministica, da quel punto ripete lo stesso tratto per sempre e non risponderà mai. Se è nondeterministica, una computazione che accetta si può accorciare togliendo il tratto tra le due ripetizioni; quindi, se , c'è una computazione che accetta entro passi.
- La macchina . Simula contando i passi; se il contatore arriva a e non si è fermata, si ferma in "no". Per il punto 2 le computazioni troncate non servono per accettare, quindi decide lo stesso linguaggio , e ogni sua computazione termina.
- Il contatore. è propria, quindi può prima eseguire e ottenere un metro di celle. Il contatore è fatto così: una cella con simboli possibili, celle con simboli di (un numero in base ), e celle usate in unario. Il suo valore massimo è proprio . A ogni passo simulato incrementa il contatore; quando trabocca, forza il "no".
- Spazio. Metro e contatore occupano celle, la simulazione di al più : in tutto .
Dove: dispensa cap. 4, p. 22; slide Lez. 4
Capitolo 6 · Classi complementari
proposizioneProposizione (le classi deterministiche sono chiuse per complemento)
chiesto in 2 domandedimostrato nel corsoSe è una classe deterministica o , allora ; per esempio .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (le classi deterministiche sono chiuse per complemento)
Intuizione
Basta scambiare gli stati "yes" e "no" della macchina deterministica.
All'esame
Serve a dire che e che, se , allora anche .
Da scrivere all'esame
SÌ: le classi deterministiche di tempo e spazio sono chiuse per complemento (per esempio ): basta scambiare "yes" e "no" nella MdT deterministica, con lo stesso budget.
Dimostrazione
Idea: in una macchina deterministica basta scambiare gli stati "yes" e "no": la computazione è la stessa, cambia solo la risposta finale.
- Sia oppure , e sia : esiste una MdT deterministica che decide entro il budget . "Decide" vuol dire che su ogni input si ferma, in "yes" se e in "no" se .
- Sia la macchina ottenuta da scambiando nel programma gli stati "yes" e "no": ogni transizione che portava in "yes" ora porta in "no", e viceversa.
- Su ogni input fa esattamente le stesse mosse di , perché la macchina è deterministica e ha una sola computazione. Quindi usa lo stesso tempo e lo stesso spazio, e si ferma nello stato opposto.
- Perciò (il complemento di ) . Cioè decide entro lo stesso budget: .
- Da qui le due inclusioni. Se , allora è il complemento di un linguaggio di , e per il punto 4 sta in : . Se , per il punto 4 , quindi , che è il complemento di , sta in : . Dunque .
- P è l'unione delle classi , ognuna chiusa per complemento, quindi .
Con una macchina nondeterministica il trucco non funziona: scambiando "yes" e "no" si accetterebbe quando esiste una computazione che rifiuta, mentre per il complemento servirebbe che tutte rifiutino.
Dove: dispensa cap. 6, p. 25; slide Lez. 4
Capitolo 7 · Teorema di gerarchia
lemmaLemma 1 (limite superiore per )
per l'oraledimostrato nel corsoPer propria, il linguaggio sta in .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Lemma 1 (limite superiore per )
Intuizione
Una macchina universale con una "sveglia" lunga simula passo per passo, e ogni passo costa .
Da scrivere all'esame
Per il Lemma 1, : una macchina universale con una sveglia lunga simula su spendendo per ogni passo.
Dimostrazione
Idea: una macchina universale simula su passo per passo, con una "sveglia" lunga che le dice quando smettere. Ogni passo simulato costa e i passi sono al più , quindi il totale è ; lo speedup lineare toglie la costante.
- Ingredienti. ha 4 nastri e combina macchine già viste: la MdT universale , la simulazione di nastri su uno solo, lo speedup lineare e la macchina della funzione propria . Sia la lunghezza dell'input .
- Sveglia. esegue su e scrive sul quarto nastro simboli, che faranno da sveglia. Costa passi, perché e non decresce.
- Preparazione. copia la descrizione di sul terzo nastro, lascia sul primo nastro la codifica di e scrive sul secondo la codifica dello stato iniziale. Controlla anche che sia la descrizione corretta di una MdT, e se non lo è rifiuta. Tutto in passi, perché .
- Simulazione di un passo. I nastri di sono scritti uno dopo l'altro sul primo nastro di , come nella simulazione multinastro. Con una prima scansione raccoglie i simboli letti dai cursori di e li scrive sul secondo nastro, dopo lo stato. Poi cerca sul terzo nastro la transizione di che corrisponde, e con una seconda scansione applica le modifiche sul primo nastro. Infine sposta di una cella il cursore della sveglia.
- Costo di un passo. ha nastri, ciascuno lungo al più celle, e ogni stato o simbolo di è codificato con bit. Il primo nastro è lungo e un passo costa , più per la ricerca sul terzo nastro. Sia sia sono al più : la codifica di uno stato o simbolo ha circa bit, e il programma ha almeno una riga per ogni combinazione di simboli, quindi la descrizione di è lunga almeno . Allora , e un passo costa , con una costante che non dipende da .
- Risposta. Se la simulazione arriva in "yes" prima che la sveglia finisca, accetta; se rifiuta, o se la sveglia arriva in fondo (sono passati passi), rifiuta. Questo è esattamente il test " accetta in al più passi", quindi decide .
- Tempo totale. Al più passi simulati, ciascuno in , più di preparazione: . Con lo speedup lineare (trattare più simboli come uno solo) si scende ad al più passi: .
Dove: dispensa cap. 7, p. 26; slide Lez. 5
lemmaLemma 2 (limite inferiore per )
per l'oraledimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Lemma 2 (limite inferiore per )
Intuizione
Diagonalizzazione: se una macchina decidesse così in fretta, la macchina che "fa il contrario" sulla propria descrizione porterebbe a una contraddizione.
Da scrivere all'esame
Per il Lemma 2, : la macchina diagonale , che fa il contrario sulla propria descrizione, porterebbe a una contraddizione.
Dimostrazione
Idea: per assurdo. Se una macchina decidesse così in fretta, potremmo costruire una macchina che, sulla propria descrizione, fa il contrario di ciò che dice quella macchina: non potrebbe né accettare né rifiutare se stessa.
- Ipotesi assurda. Supponiamo che una MdT, chiamiamola , decida in tempo , dove è la parte intera di .
- La macchina diagonale. , su input la descrizione di una macchina, esegue sull'input (cioè chiede: " accetta la propria descrizione entro passi?") e risponde il contrario: se allora "no", altrimenti "yes".
- Tempo di . Se , l'input è lungo , quindi impiega passi. Dunque , che è una MdT deterministica, si ferma sempre entro passi (trascurando, come dispensa e libro, il tempo lineare per duplicare l'input).
- Caso . Per come è fatta , , cioè . Per definizione di , non accetta la propria descrizione entro passi. Ma si ferma sempre entro passi (punto 3), quindi la rifiuta: . Contraddizione.
- Caso . Allora , cioè : accetta la propria descrizione entro passi, cioè . Contraddizione.
- Conclusione. si ferma sempre, quindi uno dei due casi deve valere, ma entrambi sono impossibili. L'ipotesi del punto 1 è falsa: .
Dove: dispensa cap. 7, p. 27; slide Lez. 5
teoremaTeorema di gerarchia per il tempo (Teorema 7.1)
★ chiesto in 30 domandedimostrato nel corsoSe è una funzione propria, allora . È stato dimostrato anche il risultato più forte .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema di gerarchia per il tempo (Teorema 7.1)
Intuizione
Con abbastanza tempo in più si risolvono problemi nuovi: con , sta nella classe grande (Lemma 1) ma non in quella piccola (Lemma 2).
All'esame
Serve a separare classi di tempo, per esempio a dimostrare .
Da scrivere all'esame
Per il teorema di gerarchia per il tempo, se è propria allora : con abbastanza tempo in più si risolvono problemi nuovi.
Dimostrazione
Idea: usiamo il linguaggio con . Il Lemma 1 lo mette nella classe grande ; il Lemma 2 lo esclude da , che contiene la classe piccola .
- Inclusione. è propria, quindi non decresce, e . Allora (l'ultimo passo vale perché ). Una macchina che sta nel budget sta anche nel budget più grande: .
- La funzione . Poniamo . Anche è propria (si calcola e poi si usa ) e , quindi i due lemmi valgono per .
- Lemma 1 per . : sta nella classe grande.
- Una disuguaglianza. vale se è pari e se è dispari, quindi è sempre . Poiché non decresce, . Dunque .
- Lemma 2 per . . Se stesse in , per il punto 4 starebbe anche in : impossibile. Quindi .
- Conclusione. sta in ma non in ; con il punto 1 l'inclusione è stretta: .
Il risultato più forte è solo citato nel corso (Problema 7.4.8 del Papadimitriou), senza prova.
Dove serve nelle tracce
F01 n. 2 · F01 n. 4 · F02 n. 1 · F02 n. 5 · F03 n. 4 · F04 n. 1 · F04 n. 6 · F05 n. 1 · F06 n. 1 · F06 n. 4 · F06 n. 5 · F07 n. 1 · F08 n. 1 · G16 n. 1 · F12 n. 7 · F13 n. 6 · F14 n. 1 · G17 n. 2 · L18 n. 2 · G20v1 n. 2 · G20v1 n. 7 · G20v2 n. 2 · G20v4 n. 2 · LU22 n. 4 · GE23 n. 4 · GE23 n. 6 · E26 n. 4 · E26 n. 7 · ND n. 3 · ND n. 5
Dove: dispensa cap. 7, p. 28; slide Lez. 5. La versione con è citata senza prova (Problema 7.4.8 del Papadimitriou).
teoremaTeorema (separazione di P ed EXP)
★ chiesto in 12 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema (separazione di P ed EXP)
Intuizione
e, per la gerarchia, .
All'esame
Serve a rispondere NO a "?" e a escludere riduzioni da problemi completi per EXP (o classi più grandi, come NEXP) verso problemi in P.
Da scrivere all'esame
: per il teorema di gerarchia , e , quindi .
Dimostrazione
Idea: tutto P sta dentro , e il teorema di gerarchia trova in EXP un problema che non sta in ; quindi quel problema non sta in P.
- . Ogni polinomio prima o poi diventa più piccolo di ; per i pochi più piccoli la differenza è solo una costante, che per lo speedup lineare non conta. Quindi ogni sta in , e così la loro unione P.
- . Per definizione EXP è l'unione delle classi , e è il caso . Con il punto 1, .
- Gerarchia. è una funzione propria e , quindi vale il teorema di gerarchia per il tempo: .
- Il gradino sta in EXP. per , quindi, a meno di costanti, .
- Conclusione. Per i punti 3 e 4 esiste un linguaggio con . Per il punto 1, (altrimenti starebbe in ). Quindi e, con il punto 2, .
Dove serve nelle tracce
F01 n. 2 · F01 n. 4 · F02 n. 1 · F02 n. 5 · F04 n. 1 · F06 n. 5 · G16 n. 1 · G17 n. 2 · G20v1 n. 2 · G20v1 n. 7 · GE23 n. 4 · E26 n. 7
Dove: dispensa cap. 7, p. 28; slide Lez. 5
teoremaTeorema di gerarchia per lo spazio (Teorema 7.2)
chiesto in 7 domandeSe è una funzione propria, allora .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema di gerarchia per lo spazio (Teorema 7.2)
Intuizione
Stessa diagonalizzazione del tempo, con versioni dei due lemmi per lo spazio; il gradino è più basso perché simulare costa poca memoria in più.
All'esame
Serve a separare classi di spazio: per esempio da si ricava .
Da scrivere all'esame
Per il teorema di gerarchia per lo spazio, con propria ; per esempio .
Schema della dimostrazione
Idea: è la stessa diagonalizzazione del tempo. Una macchina , su input la descrizione di una macchina , simula dentro un recinto di celle e fa il contrario. Il fattore in più paga la simulazione di qualunque macchina fissata, che costa solo una costante in più.
- Ipotesi. è propria e, come è implicito nell'enunciato, cresce almeno come (per budget costanti l'enunciato sarebbe falso, per la compressione dello spazio). Allora anche si può calcolare come metro.
- La macchina . Su un input lungo : (a) segna un recinto di celle; se in seguito deve uscirne, rifiuta. (b) Controlla che sia la descrizione di una macchina seguita da un numero qualsiasi di zeri; altrimenti rifiuta. (c) Simula sull'input , codificando ogni simbolo di in binario. (d) Conta i passi simulati: per il teorema di terminazione, una macchina con budget di spazio che fa più di passi è in un ciclo, e un contatore fino a quel numero occupa celle; se il contatore trabocca, rifiuta. (e) Se la simulazione finisce, risponde il contrario di .
- sta nella classe grande. non esce mai dal recinto e si ferma sempre, quindi il suo linguaggio .
- non sta nella classe piccola. Supponiamo per assurdo che una macchina decida entro il budget di spazio ; per il teorema di terminazione possiamo supporre che si fermi sempre. Simulare costa celle ( = bit per codificare un simbolo di , una costante che dipende solo da ) più per il contatore. Poiché cresce senza limite, per abbastanza grande questo spazio è minore di .
- Contraddizione. Prendiamo = descrizione di seguita da abbastanza zeri da rendere così grande. Su , completa la simulazione e risponde il contrario di . Ma decide , quindi . Assurdo.
- Conclusione. perché il budget è più grande, e per i punti 3-5 l'inclusione è stretta.
Il corso non dà la prova (rimanda al Teorema 7.2 e al Problema 7.4.9 del Papadimitriou); questo è lo schema standard.
Dove serve nelle tracce
F07 n. 5 · F08 n. 3 · G20v1 n. 7 · LU22 n. 5 · GE23 n. 3 · MA23 n. 5 · LU24 n. 5
Dove: dispensa cap. 7, p. 29; slide Lez. 5. Né la dispensa né le slide danno la prova (rimandano al Teorema 7.2 e al Problema 7.4.9 del Papadimitriou). La conseguenza è ricavata negli appunti della Lez. 5.
Capitolo 8 · Gerarchie nondeterministiche
teoremaGerarchie nondeterministiche
chiesto in 4 domande per ogni coppia di costanti . Per lo spazio, per ogni funzione crescente (anche lentissima): , , , .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Gerarchie nondeterministiche
Intuizione
Le gerarchie nondeterministiche sono molto più fitte di quelle deterministiche: basta pochissimo in più per avere problemi nuovi.
Da scrivere all'esame
Per le gerarchie nondeterministiche per : per esempio , quindi le due classi sono diverse.
Schema della dimostrazione
Idea: si usa ancora la diagonalizzazione, ma una macchina nondeterministica non può semplicemente "fare il contrario": per rifiutare dove un'altra accetta dovrebbe controllare che tutte le computazioni rifiutano, cioè risolvere il complemento. Per lo spazio questo ostacolo si supera; per il tempo si aggira con una diagonalizzazione "ritardata".
- Tempo: perché il metodo deterministico non basta. Una macchina nondeterministica veloce decide un linguaggio in , ma il suo complemento non è noto essere in (è la questione NP contro coNP). Quindi la macchina diagonale non può rovesciare la risposta su ogni input.
- Tempo: diagonalizzazione ritardata. La macchina diagonale lavora su input ( uni). A ogni macchina dell'elenco assegna un intervallo di lunghezze da a , con esponenzialmente più grande di . Per , su copia la risposta di su , simulandola nondeterministicamente per passi: copiare è facile anche per una macchina nondeterministica. Per , su calcola in modo deterministico, provando tutte le scelte, la risposta di su e la rovescia. Questo costa circa passi, che è polinomiale in perché è enorme. Così lavora in tempo .
- Tempo: la contraddizione. Se decidesse in tempo , allora sull'intervallo varrebbe , e quest'ultima risposta è il contrario di . Assurdo. (Ogni macchina compare infinite volte nell'elenco, così si scavalcano le costanti della simulazione.) Dunque .
- Spazio. Per il teorema di Immerman e Szelepcsényi lo spazio nondeterministico (almeno ) è chiuso per complemento. Quindi la macchina diagonale può rovesciare la risposta anche nondeterministicamente, e la prova della gerarchia di spazio deterministica si ripete, con un gradino più fitto: se (cioè tende a 0) e , allora .
- Gli esempi. Con crescente, quindi illimitata, tende a 0, e lo stesso vale per e (per si controlla anche ). Per invece è molto più grande di : per questo il gradino scelto è , che soddisfa entrambe le condizioni.
Il corso enuncia questi risultati senza prova (articoli citati nella nota 7.4.10 del Papadimitriou); questo è uno schema delle prove standard.
Dove: dispensa cap. 8, p. 29; slide Lez. 5
Capitolo 9 · Tempo dato lo spazio
teoremaTempo dato lo spazio (Hopcroft, Paul e Valiant)
chiesto in 3 domande; più precisamente .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Tempo dato lo spazio (Hopcroft, Paul e Valiant)
Intuizione
Ogni cella usata è costata almeno un passo per raggiungerla, quindi lo spazio non supera mai il tempo.
All'esame
Dà ; se un problema non si risolve in spazio polinomiale non si risolve neanche in tempo polinomiale.
Da scrivere all'esame
SÌ: , perché ogni cella usata costa almeno un passo per raggiungerla; per esempio .
Schema della dimostrazione
Idea: a ogni passo una testina si sposta di al più una cella, quindi in passi la macchina non può raggiungere più di celle nuove. Lo spazio usato non supera mai il tempo.
- Sia : una MdT deterministica decide facendo al più passi su ogni input lungo . Qui è il budget di tempo.
- Una cella di un nastro di lavoro viene usata solo quando la testina ci arriva sopra (è l'equivalente di una "new" o di una "malloc"). La testina parte dalla prima cella e a ogni passo si sposta di al più una posizione. Quindi dopo passi ha toccato al più celle.
- Con al più passi, ogni nastro di lavoro usa al più celle; con un numero costante di nastri lo spazio totale è . Le costanti moltiplicative non contano (compressione lineare dello spazio), quindi la stessa rispetta un budget di spazio : .
- Raffinamento (Hopcroft, Paul e Valiant, 1975; nel corso è solo citato, Problema 7.4.17 del Papadimitriou). Schema: si divide il tempo in intervalli di passi e ogni nastro in blocchi di celle. Il contenuto di un blocco alla fine di un intervallo dipende solo da un numero costante di blocchi alla fine degli intervalli precedenti: si ottiene un grafo delle dipendenze con circa nodi. Un argomento di "gioco dei sassolini" (pebbling) mostra che i nodi di questo grafo si possono ricalcolare tenendo in memoria contemporaneamente solo blocchi. Ogni blocco occupa celle, e scegliendo in modo opportuno lo spazio totale diventa .
Conseguenza: con polinomiale si ha ; un problema che non si risolve in spazio polinomiale non si risolve neanche in tempo polinomiale.
Dove serve nelle tracce
Dove: dispensa cap. 9, p. 29; slide Lez. 5. è giustificato nelle slide; il raffinamento con è citato senza prova (Problema 7.4.17 del Papadimitriou).
Capitolo 10 · Spazio dato il tempo
teoremaSpazio dato il tempo
★ chiesto in 25 domandedimostrato nel corso per una costante ; in particolare .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Spazio dato il tempo
Intuizione
Una macchina con spazio ha un numero di configurazioni esponenziale in : se fa più passi di così è in un ciclo.
All'esame
Dà (non si sa se l'inclusione è stretta).
Da scrivere all'esame
, perché una macchina con budget di spazio ha al più configurazioni; quindi .
Dimostrazione
Idea: con un budget di spazio limitato la macchina ha solo un numero finito di "fotografie" possibili (configurazioni), esponenziale nel budget. Una macchina deterministica che si ferma non ripete mai una fotografia, quindi fa al più tanti passi quante sono le configurazioni.
- Sia : una MdT deterministica con nastri decide usando al più celle per nastro di lavoro ( è il budget di spazio). Come sempre nel corso per lo spazio, .
- Una configurazione di è tutto ciò che serve per proseguire la computazione: lo stato, la posizione della testina sull'input (che non cambia mai contenuto) e, per ogni nastro di lavoro, il contenuto e la posizione della testina.
- Contiamo le configurazioni: al più stati ( = insieme degli stati) per posizioni sull'input per, su ogni nastro di lavoro, contenuti ( = alfabeto) e posizioni. Poiché , si ha , e inoltre ; quindi il totale è al più per una costante che dipende solo da (non dall'input).
- è deterministica: ogni configurazione determina in modo unico la successiva. Se passasse due volte dalla stessa configurazione, da lì in poi ripeterebbe la stessa sequenza all'infinito, cioè non si fermerebbe mai.
- Ma decide , quindi si ferma su ogni input. Allora tutte le configurazioni attraversate sono diverse, e i passi sono al più . (Le slide lo dicono anche così: se una macchina supera passi è in ciclo, e si può fermarla con "no".)
- Quindi con .
Con si ottiene , che è ancora esponenziale: (non si sa se l'inclusione è stretta).
Dove serve nelle tracce
F01 n. 1 · F02 n. 5 · F03 n. 4 · F04 n. 6 · F05 n. 1 · F06 n. 1 · F06 n. 4 · F07 n. 1 · F08 n. 1 · F12 n. 7 · F13 n. 6 · L18 n. 1 · L18 n. 4 · G20v2 n. 2 · G20v4 n. 2 · LU22 n. 4 · FE23 n. 4 · MA23 n. 6 · SE23 n. 3 · SE23 n. 5 · LU24 n. 1 · LU24 n. 6 · E26 n. 4 · E26 n. 6 · ND n. 5
Dove: dispensa cap. 10, p. 29; slide Lez. 5
Capitolo 11 · Deterministico vs nondeterministico (Savitch)
proposizioneTeorema 7.4 (a)
per l'oraledimostrato nel corso e .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 7.4 (a)
Intuizione
Le MdT deterministiche sono casi particolari di quelle nondeterministiche.
All'esame
Inclusioni di base come , e .
Da scrivere all'esame
SÌ, per il Teorema 7.4 (a): una MdT deterministica è un caso particolare di nondeterministica, quindi e .
Dimostrazione
Idea: una MdT deterministica è una MdT nondeterministica che, in ogni situazione, ha una sola scelta.
- Una MdT deterministica ha una funzione di transizione che associa a ogni coppia (stato, simbolo letto) un'unica azione. Una MdT nondeterministica ha invece una relazione che può associare a una coppia più azioni.
- Prendiamo come proprio (una sola azione per coppia). Otteniamo una MdT nondeterministica che fa esattamente le stesse mosse di .
- ha un solo ramo di computazione, identico alla computazione di . Una MdT nondeterministica accetta se almeno un ramo arriva a "yes": qui c'è un solo ramo, quindi accetta se e solo se accetta . Le due macchine decidono lo stesso linguaggio.
- Le risorse sono le stesse: il tempo di è la lunghezza del suo unico ramo, cioè il tempo di , al più (budget di tempo); le celle usate sono le stesse, al più (budget di spazio).
- Quindi implica , e implica .
Prendendo l'unione sui budget polinomiali o logaritmici: , , , . Il nondeterminismo non toglie problemi, al più ne aggiunge.
Dove: slide Lez. 5; dispensa cap. 11, p. 32 (usato nel corollario PSPACE = NPSPACE)
teoremaTeorema 7.4 (b)
chiesto in 3 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 7.4 (b)
Intuizione
Si provano le sequenze di scelte una alla volta riusando lo stesso spazio: ogni computazione è lunga al più .
All'esame
Dà .
Da scrivere all'esame
SÌ, per il Teorema 7.4 (b) (si provano i rami uno alla volta riusando lo spazio); per esempio .
Dimostrazione
Idea: si provano tutti i rami della macchina nondeterministica uno alla volta, cancellando e riusando lo stesso spazio. Ogni ramo è lungo al più passi, quindi usa al più celle.
- Sia : una MdT nondeterministica decide e ogni suo ramo fa al più passi (budget di tempo ). Sia il grado di nondeterminismo di : il numero massimo di scelte possibili in una coppia (stato, simbolo). è una costante che dipende solo da .
- Un ramo è individuato dalla sequenza delle scelte fatte: una sequenza di al più interi tra 1 e . Ogni intero occupa simboli, quindi una sequenza occupa celle, perché è costante.
- Lungo un singolo ramo usa al più celle per nastro: serve almeno un passo per ogni cella nuova (come in ).
- La MdT deterministica fa così: genera le sequenze di scelte una dopo l'altra (come un contatore in base con cifre). Per ciascuna cancella i nastri di lavoro e simula seguendo quelle scelte. Se la simulazione arriva a "yes", accetta. Se nessuna sequenza porta a "yes", rifiuta.
- Correttezza: accetta se e solo se almeno un ramo arriva a "yes", cioè se e solo se almeno una sequenza fa accettare .
- Spazio: in ogni momento tiene la sequenza corrente, , più lo spazio della simulazione di un ramo, , che viene riusato dal ramo successivo. In totale , cioè . (Il tempo di invece è esponenziale, circa rami, ma qui conta solo lo spazio.)
Con polinomiale: .
Dove serve nelle tracce
Dove: dispensa cap. 11, p. 30; slide Lez. 5
teoremaTeorema 7.4 (c)
chiesto in 5 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 7.4 (c)
Intuizione
Si risolve REACHABILITY sul grafo delle configurazioni, che ha un numero di nodi esponenziale in .
All'esame
Con dà .
Da scrivere all'esame
SÌ, per il Teorema 7.4 (c) (REACHABILITY sul grafo delle configurazioni); con dà .
Dimostrazione
Idea (metodo della raggiungibilità): si costruisce il grafo delle configurazioni della macchina nondeterministica; è accettato se e solo se dalla configurazione iniziale si raggiunge una configurazione che accetta. Il grafo ha nodi e REACHABILITY si risolve in tempo polinomiale nel numero di nodi.
- Sia una MdT nondeterministica con nastri che decide con budget di spazio . Una configurazione di è : lo stato e, per ogni nastro, la parte a sinistra della testina e quella a destra .
- Si può accorciare: il nastro di input contiene sempre , quindi basta la posizione della sua testina; il nastro di output non serve (basta fermarsi in "yes" o "no"). Resta , dove ogni nastro di lavoro è lungo al più per il budget di spazio.
- Il numero di configurazioni è al più ( = stati, = alfabeto). Poiché , questo è al più per una costante che dipende solo da .
- Grafo delle configurazioni : nodi = configurazioni; arco da a se passa da a con una mossa. Allora ha una computazione che accetta in c'è un cammino dalla configurazione iniziale a una configurazione con stato "yes".
- REACHABILITY su un grafo con nodi si risolve in tempo (visita del grafo). Con il tempo è per una costante .
- Il grafo non va scritto in anticipo: quando l'algoritmo chiede se è un arco, si simula una mossa di da ( determina tutte le possibili successive). Questo costa tempo polinomiale nella lunghezza di una configurazione, che non cambia il limite.
Quindi . Con : , un polinomio, quindi .
Dove serve nelle tracce
F02 n. 6 · F06 n. 7 · F12 n. 1 · G20v3 n. 7 · SP n. 5
Dove: dispensa cap. 11, p. 30; slide Lez. 5. La dispensa omette la prova; le slide della Lez. 5 la svolgono.
corollarioCorollario (catena )
★ chiesto in 13 domande.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario (catena )
Intuizione
Si ottiene mettendo insieme il Teorema 7.4 (a), (b) e (c).
All'esame
È la catena da citare nelle risposte SÌ "per inclusione".
Da scrivere all'esame
Per la catena , che segue dal Teorema 7.4 (a), (b) e (c).
Schema della dimostrazione
Idea: ogni anello della catena è un caso particolare del Teorema 7.4, con il budget scelto in modo opportuno.
- . e . Per il Teorema 7.4 (a) con budget di spazio : .
- . Per il Teorema 7.4 (c) con : . Ora , che è un polinomio perché è una costante. Quindi .
- . P è l'unione dei e NP l'unione degli . Per il Teorema 7.4 (a) ogni .
- . Per il Teorema 7.4 (b) ogni , che è contenuto in PSPACE (unione degli ).
- Mettendo insieme i quattro passi: .
Per il teorema di gerarchia di spazio , quindi almeno una di queste inclusioni è stretta, ma non si sa quale.
Dove serve nelle tracce
F01 n. 4 · F01 n. 7 · F02 n. 4 · F05 n. 6 · F06 n. 2 · G17 n. 2 · L18 n. 7 · G20v1 n. 7 · G20v3 n. 4 · G20v3 n. 7 · LU22 n. 5 · MA23 n. 3 · ND n. 7
Dove: dispensa cap. 11, p. 30; slide Lez. 5. Nelle slide è lasciato come esercizio.
teoremaTeorema di Savitch (Teorema 7.5)
chiesto in 7 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema di Savitch (Teorema 7.5)
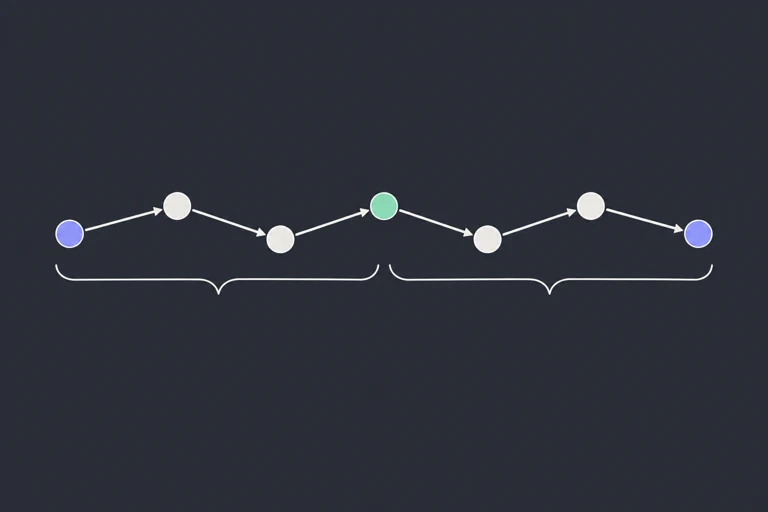
Intuizione
Un cammino lungo al più da a ha un punto di mezzo : si prova ogni ricorsivamente riusando lo spazio; la ricorsione è profonda e ogni livello usa celle.
All'esame
È la base dei corollari e .
Da scrivere all'esame
Per il teorema di Savitch : si cerca ricorsivamente il punto di mezzo del cammino, con ricorsione profonda e bit per livello.
Dimostrazione
Idea: un cammino da a lungo al più ha un nodo di mezzo , da cui e distano al più . Si prova ogni , uno alla volta, risolvendo ricorsivamente le due metà e riusando lo spazio. La ricorsione è profonda e ogni livello ricorda solo bit.
- Il predicato. Sia un grafo con nodi, e due nodi, . vale se in c'è un cammino da a lungo al più . Se è raggiungibile da , c'è un cammino senza nodi ripetuti, quindi lungo al più . Perciò REACHABILITY equivale a decidere .
- Caso base . Un cammino lungo al più esiste se oppure se è un arco: basta guardare una casella della matrice di adiacenza sul nastro di input.
- Passo ricorsivo . vale se e solo se esiste un nodo con e . Perché: se c'è un cammino lungo al più , il nodo a metà lo divide in due pezzi lunghi al più ; viceversa, attaccando due cammini lunghi al più si ottiene un cammino lungo al più .
- La macchina. Ha il nastro di input (la matrice di , solo lettura) e due nastri di lavoro. Il primo fa da pila dei record di attivazione: contiene triple scritte in binario, con il problema corrente più a destra. Il secondo è spazio di appoggio di celle (contatore per enumerare i nodi).
- Come si esegue la ricorsione. Per ogni nodo , uno dopo l'altro: si aggiunge in cima la tripla e la si risolve ricorsivamente. Se la risposta è no, si cancella la tripla e si passa allo successivo. Se è sì, si sovrascrive con ( si legge dalla tripla a sinistra) e la si risolve. Se è no, si cancella e si passa allo successivo; se è sì, confrontando con la tripla a sinistra la macchina capisce che era la seconda chiamata, cancella e risponde sì a . Se nessuno funziona, risponde no.
- Correttezza. Per induzione su : per vale il passo 2; se la macchina risponde bene per , allora per il passo 3 risponde bene per .
- Spazio. Ogni chiamata ricorsiva abbassa di 1 partendo da , quindi sulla pila ci sono al più () triple. Ogni tripla contiene due nodi ( bit ciascuno) e : al più simboli. Quando una chiamata finisce la sua tripla viene cancellata, così lo spazio per i vari è riusato. Totale: .
Quindi . Attenzione: il tempo è circa , non polinomiale; Savitch risparmia spazio, non tempo.
Problemi
Dove: dispensa cap. 11, p. 30; slide Lez. 5
corollarioCorollario di Savitch (spazio nondeterministico)
chiesto in 7 domandedimostrato nel corsoPer ogni funzione propria : .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario di Savitch (spazio nondeterministico)
Intuizione
Si applica l'algoritmo di Savitch al grafo delle configurazioni, che ha nodi: .
All'esame
Togliere il nondeterminismo costa solo un quadrato nello spazio, mentre nel tempo (per quanto si sa) costa un esponenziale.
Da scrivere all'esame
SÌ, per il corollario di Savitch per propria; per esempio .
Dimostrazione
Idea: è accettato se e solo se nel grafo delle configurazioni c'è un cammino dalla configurazione iniziale a quella che accetta. Si applica l'algoritmo di Savitch a questo grafo, che ha nodi, senza mai scriverlo: lo spazio è .
- Sia : una MdT nondeterministica decide con budget di spazio , dove è una funzione propria (calcolabile in spazio ).
- Configurazioni. Come nel Teorema 7.4 (c), una configurazione di su è descritta da stato, posizione sull'input e contenuto dei nastri di lavoro: simboli, perché . Il numero di configurazioni è al più .
- Riduzione a raggiungibilità. se e solo se nel grafo delle configurazioni c'è un cammino dalla configurazione iniziale a una che accetta. Possiamo supporre che , prima di accettare, cancelli i nastri e riporti le testine all'inizio: allora c'è un'unica configurazione che accetta, .
- Savitch senza scrivere il grafo. Eseguiamo l'algoritmo di Savitch con , e . I nodi da provare sono tutte le stringhe lunghe : per enumerarle serve conoscere , ed è per questo che deve essere propria. Quando, nel caso base, serve sapere se è un arco, non si consulta una matrice: si controlla se segue da con una mossa di , leggendo il simbolo di sotto la testina e la relazione . Questo usa spazio .
- Spazio. La pila ha triple (profondità della ricorsione) e ogni tripla contiene due configurazioni e un intero, cioè simboli. Totale ; in formula, . Lo spazio per il controllo degli archi, , è minore.
Quindi : togliere il nondeterminismo costa al più un quadrato nello spazio.
Dove: dispensa cap. 11, p. 31; slide Lez. 5
corollarioCorollario:
chiesto in 7 domandedimostrato nel corso: il nondeterminismo non aggiunge problemi risolubili in spazio polinomiale.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario:
Intuizione
Il quadrato di un polinomio è ancora un polinomio.
All'esame
Serve a rispondere SÌ a "?" e a dire che un problema PSPACE-completo e uno NPSPACE-completo si riducono l'uno all'altro.
Da scrivere all'esame
SÌ: per il corollario di Savitch (), quindi .
Dimostrazione
Idea: un'inclusione è banale; per l'altra, il corollario di Savitch trasforma un budget di spazio polinomiale nondeterministico in un budget al quadrato deterministico, e il quadrato di un polinomio è ancora un polinomio.
- . PSPACE è l'unione degli e NPSPACE l'unione degli . Per il Teorema 7.4 (a), per ogni .
- . Sia : allora per qualche , cioè ha un budget di spazio .
- Il budget è una funzione propria e vale , quindi si può applicare il corollario di Savitch: .
- è ancora un polinomio, quindi e .
- Le due inclusioni danno .
Conseguenze: un problema è PSPACE-completo se e solo se è NPSPACE-completo. Per il tempo la situazione è diversa: se non si sa.
Classi
Dove: dispensa cap. 11, p. 32; dispensa cap. 14, p. 57 (esercizio 3); slide Lez. 5
Capitolo 12 · Riduzioni (Cook-Levin)
proposizioneProposizione (composizione di riduzioni)
chiesto in 3 domandedimostrato nel corsoSe è una riduzione da a e è una riduzione da a , allora è una riduzione da a (ancora in spazio logaritmico).
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (composizione di riduzioni)
Intuizione
non si scrive per intero: ogni volta che serve un suo simbolo lo si ricalcola, tenendo solo un contatore di bit.
All'esame
Le riduzioni sono transitive: per mostrare che è NP-completo basta ridurre a un problema già NP-completo.
Da scrivere all'esame
SÌ, perché le riduzioni (in spazio logaritmico) si compongono: se si riduce a e a , allora si riduce a .
Dimostrazione
Idea: che dia la risposta giusta è immediato. Il problema è lo spazio: è troppo lungo per essere scritto in spazio logaritmico. Allora non lo si scrive mai: ogni volta che serve un suo simbolo lo si ricalcola, ricordando solo la posizione con un contatore di bit.
- Correttezza. (perché è una riduzione) (perché è una riduzione, applicata alla stringa ).
- Il problema. Siano e le macchine che calcolano e in spazio logaritmico. L'idea ingenua è calcolare su un nastro di lavoro e poi eseguire su di esso; ma può essere molto più lungo di (), quindi lo spazio non sarebbe più logaritmico.
- Lunghezza di . lavora in spazio , quindi ha un numero polinomiale di configurazioni e si ferma in tempo polinomiale. Allora per una costante , e una posizione in si scrive in binario con bit.
- Il trucco. La macchina composta simula e tiene in un contatore la posizione della testina di input di (cioè la posizione in ). Se la testina va a destra, aumenta di 1 e fa proseguire su (su nastri separati) finché produce il simbolo successivo, che è quello letto da . Se la testina resta ferma, ricorda il simbolo letto. Se va a sinistra, diminuisce di 1 e riesegue su dall'inizio, contando i simboli prodotti senza scriverli, finché arriva all'-esimo.
- Spazio. Il contatore e il contatore dei simboli prodotti: . Nastri di lavoro di : . Nastri di lavoro di : . Totale . Il tempo cresce per i ricalcoli, ma resta polinomiale e comunque non conta.
Quindi è una riduzione da a : le riduzioni sono transitive. Per mostrare che è NP-completo basta allora mostrare e ridurre a un problema già NP-completo : ogni problema di NP si riduce ad , e componendo si riduce a .
Dove: dispensa cap. 12, p. 34; appunti Lez. 7
proposizioneChiusura delle classi rispetto alle riduzioni
★ chiesto in 39 domandeP, NP, coNP, L, NL, PSPACE ed EXP sono chiuse rispetto alle riduzioni: se sta nella classe e si riduce a , anche sta nella classe.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Chiusura delle classi rispetto alle riduzioni
Intuizione
Le riduzioni lavorano in spazio logaritmico, quindi in tempo polinomiale: premetterle a un algoritmo non fa uscire dalla classe.
All'esame
È la mossa base delle risposte "solo se": se un problema completo per stesse in (chiusa), allora .
Da scrivere all'esame
Solo se : è chiusa rispetto alle riduzioni, quindi se un problema -completo stesse in , tutti i problemi di (che si riducono a lui) starebbero in .
Schema della dimostrazione
Idea: per decidere si calcola e poi si esegue su l'algoritmo per . La riduzione costa solo spazio logaritmico (quindi tempo polinomiale e output di lunghezza polinomiale), un costo che tutte queste classi possono permettersi.
- Situazione. sta nella classe , e è una riduzione da a : , con calcolabile in spazio . Come nella composizione di riduzioni, si calcola in tempo polinomiale e .
- P, NP. Si calcola in tempo polinomiale, poi si esegue l'algoritmo per (deterministico per P, nondeterministico per NP) in tempo . Un polinomio di un polinomio è un polinomio, quindi (o NP).
- EXP. Uguale: il tempo è , ancora esponenziale.
- PSPACE. Si scrive ( celle) e si esegue l'algoritmo per in spazio : polinomiale.
- L, NL. Qui non si può scrivere (è troppo lungo). Si usa il trucco della composizione di riduzioni: si simula la macchina per e, ogni volta che legge l'-esimo simbolo di , lo si ricalcola eseguendo da capo. Contatori e nastri: . Per NL la macchina per è nondeterministica, ma i ricalcoli di sono deterministici, quindi tutto resta nondeterministico in spazio logaritmico.
- coNP. vuol dire che il complemento di sta in NP. La stessa dà , cioè riduce il complemento di al complemento di . Per il punto 2 il complemento di sta in NP, quindi .
- Conseguenza 1 (le risposte "solo se"). Se è -completo, è chiusa rispetto alle riduzioni e , allora . Perché: ogni si riduce a ( è -hard), , e è chiusa, quindi . Esempi: un problema NP-completo in P dà , cioè ; un problema PSPACE-completo in NP dà .
- Conseguenza 2. Se è -completo e , allora è -hard: ogni problema di sta anche in , quindi si riduce a . Esempio: SAT è hard per P e per NL. Attenzione: per essere -completo serve anche , che in generale non si sa.
Il ragionamento non si applica a classi con budget fisso come : può essere lungo e il budget va calcolato su quella lunghezza.
Dove serve nelle tracce
F01 n. 2 · F02 n. 1 · F03 n. 1 · F03 n. 4 · F05 n. 5 · F05 n. 6 · F05 n. 7 · F06 n. 2 · F07 n. 4 · F07 n. 7 · F08 n. 7 · G16 n. 1 · G16 n. 4 · G16 n. 6 · F12 n. 2 · F13 n. 4 · F13 n. 6 · F14 n. 1 · F14 n. 7 · G17 n. 2 · G20v1 n. 4 · G20v2 n. 3 · G20v2 n. 7 · G20v3 n. 1 · G20v3 n. 3 · G20v4 n. 1 · G20v4 n. 2 · G20v4 n. 4 · G20v5 n. 7 · MZ22 n. 2 · LU22 n. 7 · GE23 n. 4 · GE23 n. 7 · MA23 n. 2 · LU24 n. 1 · E26 n. 5 · E26 n. 7 · ND n. 6 · ND n. 7
Dove: dispensa cap. 12, p. 35; appunti Lez. 7
proposizioneProposizione (un problema completo per due classi)
per l'oraledimostrato nel corsoSe e sono chiuse rispetto alle riduzioni e un linguaggio è completo per entrambe, allora .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (un problema completo per due classi)
Intuizione
Ogni problema di si riduce a , che sta in , quindi sta in ; e viceversa.
All'esame
Per esempio: un problema sia NP-completo sia coNP-completo darebbe .
Da scrivere all'esame
Solo se : un linguaggio completo per due classi chiuse rispetto alle riduzioni le fa coincidere.
Dimostrazione
Idea: tutto si riduce a , che sta in ; la chiusura di porta tutto dentro . Per simmetria vale anche il contrario.
- Ricordiamo: è -completo se (appartenenza) e ogni linguaggio di si riduce a (difficoltà). è chiusa rispetto alle riduzioni se, quando e si riduce a , anche .
- . Sia . Poiché è -completo, si riduce a . Poiché è anche -completo, in particolare . Poiché è chiusa rispetto alle riduzioni, .
- . Stesso ragionamento scambiando i ruoli: ogni si riduce a (-completo), (-completo), e è chiusa, quindi .
- Le due inclusioni danno .
Esempio d'esame: NP e coNP sono chiuse rispetto alle riduzioni; quindi un problema sia NP-completo sia coNP-completo darebbe . Per questo si crede che nessun problema sia entrambe le cose.
Dove: dispensa cap. 12, p. 35; appunti Lez. 7
corollarioCorollario (classe piccola con un problema completo per la grande)
per l'oraledimostrato nel corsoSe , è chiusa rispetto alle riduzioni e contiene un problema -completo, allora .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario (classe piccola con un problema completo per la grande)
Intuizione
Tutto si riduce a quel problema, e la chiusura di porta tutto dentro .
All'esame
Per esempio: un problema NP-completo sta in P solo se ; QSAT sta in NP solo se .
Da scrivere all'esame
Solo se : ed è chiusa rispetto alle riduzioni, quindi se contenesse un problema NP-completo sarebbe .
Dimostrazione
Idea: tutto si riduce al problema -completo , che sta in ; la chiusura di porta tutto dentro . L'altra inclusione è un'ipotesi.
- Ipotesi: ; è chiusa rispetto alle riduzioni; ed è -completo (ogni linguaggio di si riduce a ). Resta da mostrare .
- Per assurdo, supponiamo che esista con .
- Poiché è -completo e , si riduce a .
- Poiché e è chiusa rispetto alle riduzioni, . Questo contraddice il passo 2.
- Quindi ; insieme all'ipotesi si ottiene .
Esempi: e P è chiusa, quindi un problema NP-completo sta in P solo se . e NP è chiusa, quindi QSAT (PSPACE-completo) sta in NP solo se . Letto al contrario: se , nessun problema NP-completo sta in P.
Dove: dispensa cap. 12, p. 36; appunti Lez. 7
teoremaTeorema di Cook-Levin
★ chiesto in 11 domandedimostrato nel corsoSAT è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema di Cook-Levin
Intuizione
Una computazione nondeterministica polinomiale si descrive con una tabella , e la tabella si scrive come una formula in CNF che è soddisfacibile se e solo se esiste una computazione che accetta.
All'esame
È il primo problema NP-completo: tutte le altre prove di NP-completezza partono da SAT con catene di riduzioni.
Da scrivere all'esame
SAT è NP-completo per il teorema di Cook-Levin: ogni problema in NP si riduce a SAT, e .
Dimostrazione
Idea: SAT sta in NP perché un'assegnazione si indovina e si controlla in fretta. Per la difficoltà, la computazione di una macchina NP si scrive come una tabella (righe = tempi, colonne = celle); una formula in CNF descrive la tabella e impone che sia una computazione corretta che accetta.
- . Data in CNF, una MdT nondeterministica sceglie un valore per ogni variabile e controlla in tempo polinomiale che ogni clausola abbia un letterale vero.
- Impostazione. Sia , decisa da una MdT nondeterministica a un nastro con budget di tempo polinomiale . Stati ( iniziale), simboli ( è il blank). Sia : in passi la testina tocca al più celle, quindi bastano righe e colonne. Supponiamo che , arrivata in "yes", resti ferma lì fino al tempo (si aggiungono a mosse che non cambiano nulla): così accettare vuol dire "stato yes al tempo ".
- Variabili. = "al tempo la cella contiene "; = "al tempo lo stato è "; = "al tempo la testina è sulla cella ". Sono variabili, un numero polinomiale.
- Esattamente uno. Per ogni : (almeno una posizione) e per ogni (non due). Clausole analoghe impongono esattamente un simbolo per cella e tempo, ed esattamente uno stato per tempo. Così ogni riga descrive una sola configurazione.
- Riga iniziale. Clausole di un letterale: per l'input , e (blank) per le celle da a .
- Le celle lontane dalla testina non cambiano. , che in CNF è la clausola .
- Mosse lecite. Per ogni combinazione che NON è in e per ogni , vietiamo che accada: , cioè la clausola . Lo stesso per (con ) e per (con ). Si aggiunge : la testina si sposta di al più una cella. Così il passaggio da una riga alla successiva segue per forza una mossa di .
- Accettazione. La clausola .
- Se , è soddisfacibile. ha una computazione che accetta ; diamo a ogni variabile il valore che descrive quella computazione (prolungata fino a restando in yes). Ogni clausola è vera per costruzione.
- Se è soddisfacibile, . Per il passo 4 ogni riga descrive una configurazione ; per il passo 5 è quella iniziale su ; per i passi 6 e 7 ogni segue da con una mossa di ; per il passo 8 lo stato finale è yes. Quindi è una computazione di che accetta .
- Spazio logaritmico. Le clausole sono , un numero polinomiale, e si stampano una alla volta usando pochi contatori (, , indici di simboli e stati) che arrivano al più a : ciascuno ha bit.
Quindi ogni si riduce a SAT, e : SAT è NP-completo.
Dove serve nelle tracce
F04 n. 1 · F05 n. 6 · F12 n. 2 · F12 n. 5 · F13 n. 3 · F14 n. 6 · L18 n. 5 · GE23 n. 5 · FE23 n. 2 · SE23 n. 1 · ND n. 7
Classi
Problemi
Dove: dispensa cap. 12, p. 36; appunti Lez. 7. La dispensa dà anche la versione con i circuiti (ogni si riduce a CIRCUIT SAT, che si riduce a SAT); il riepilogo del cap. 22 elenca anche CIRCUIT SAT come NP-completo.
teorema3-SAT è NP-completo
chiesto in 1 domanda3-SAT (SAT con clausole di 3 letterali) è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
3-SAT è NP-completo
Intuizione
Si riduce SAT a 3-SAT, spezzando le clausole lunghe con variabili nuove.
All'esame
È il punto di partenza più comodo per le riduzioni ai problemi su grafi e insiemi.
Da scrivere all'esame
3-SAT è NP-completo (SAT si riduce a 3-SAT spezzando le clausole lunghe con variabili nuove), quindi ogni problema in NP si riduce a 3-SAT.
Schema della dimostrazione
Idea: 3-SAT sta in NP come SAT. Per la difficoltà riduciamo SAT a 3-SAT: ogni clausola diventa un gruppo di clausole con esattamente 3 letterali; le clausole lunghe si spezzano con variabili nuove che fanno da "catena" tra i pezzi.
- . È un caso particolare di SAT: si indovina un'assegnazione e la si controlla in tempo polinomiale.
- Clausole corte. Un letterale è una variabile o la sua negazione. diventa e diventa : ripetere un letterale non cambia il significato. Le clausole da 3 restano uguali.
- Clausole lunghe. con diventa, con variabili nuove usate solo qui: .
- Se è vera, i pezzi si possono soddisfare tutti. Sia un letterale vero. Rendiamo vere le dei pezzi prima di quello che contiene ( vera per ) e false le altre. Allora i pezzi prima sono soddisfatti dalla loro positiva, il pezzo di da , i pezzi dopo dalla loro .
- Se tutti gli sono falsi, i pezzi non si possono soddisfare tutti. Il primo pezzo obbliga vera; allora il secondo obbliga vera; e così via fino a vera. Ma allora l'ultimo pezzo è falso.
- Equivalenza. Se è soddisfacibile, per il passo 4 l'assegnazione si estende alle e soddisfa . Se è soddisfatta, per il passo 5 ogni clausola originale ha un letterale vero, quindi la stessa assegnazione (senza le ) soddisfa .
- Spazio logaritmico. Si scorrono le clausole una alla volta, con un contatore per numerare le variabili nuove: bit. ha lunghezza lineare in .
Ogni problema di NP si riduce a SAT (Cook-Levin) e SAT a 3-SAT; componendo le riduzioni, 3-SAT è NP-completo.
Dove serve nelle tracce
Classi
Dove: dispensa cap. 12, p. 39; appunti Lez. 8. La dispensa dice solo che si riduce SAT a 3-SAT; la tecnica di spezzare le clausole è descritta negli appunti.
proposizione
chiesto in 6 domande2-SAT (SAT con clausole di 2 letterali) si risolve in tempo polinomiale.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Intuizione
Si riduce alla ricerca di cicli in un grafo di dimensione lineare: con due letterali per clausola le scelte sono obbligate.
All'esame
Contrasto classico con 3-SAT; per esempio la riduzione da 2-SAT a CLIQUE esiste perché e CLIQUE è NP-completo.
Da scrivere all'esame
SÌ: (si cercano cicli nel grafo delle implicazioni), quindi si riduce a ogni problema NP-completo, per esempio CLIQUE.
Schema della dimostrazione
Idea: una clausola equivale alle due implicazioni e . Le scriviamo come archi di un grafo sui letterali; la formula è insoddisfacibile esattamente quando, per qualche variabile , da si arriva a e da si torna a (un ciclo che passa per e ).
- Grafo delle implicazioni. Data con variabili e clausole di 2 letterali, il grafo ha nodi, uno per ogni letterale e . Per ogni clausola mettiamo gli archi e (con ). La dimensione è lineare in .
- Gli archi propagano la verità. Se un'assegnazione soddisfa e c'è l'arco , allora vero vuol dire falso, e la clausola obbliga vero. Seguendo un cammino ( = "c'è un cammino"), se è vero lo è anche .
- Simmetria. Gli archi vengono a coppie: c'è se e solo se c'è . Quindi se c'è un cammino c'è anche .
- Se e , è insoddisfacibile. Se è vero, per il passo 2 anche è vero: assurdo. Se è falso, è vero e quindi anche : assurdo.
- Altrimenti è soddisfacibile. Finché resta una variabile senza valore, scegliamo un suo letterale senza cammino (esiste, perché per ipotesi uno dei due cammini manca) e rendiamo veri e tutti i letterali raggiungibili da . Non nasce contraddizione: se da si raggiungesse oltre a , per la simmetria , quindi , contro la scelta di ; e se si raggiungesse un letterale già reso falso, per simmetria con già vero, quindi avrebbe già un valore. Alla fine l'insieme dei letterali veri è chiuso rispetto agli archi, quindi ogni clausola è vera: se è falso, è vero e l'arco rende vero .
- Tempo polinomiale. Per ogni variabile si controlla con due visite del grafo (REACHABILITY) se e : visite su un grafo di dimensione lineare.
Quindi .
Classi
Dove: dispensa cap. 12, p. 39; dispensa cap. 13, p. 51 (esercizio 2); appunti Lez. 8
proposizioneHORN-SAT in tempo lineare
Una formula di Horn (clausole con al più un letterale positivo) è soddisfacibile se e solo se ha un'assegnazione che la soddisfa calcolabile in tempo lineare; quindi .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
HORN-SAT in tempo lineare
Intuizione
Si rendono veri solo i letterali obbligati dalle clausole.
All'esame
Altro caso di SAT ristretto che diventa facile.
Da scrivere all'esame
SÌ: , perché si rendono vere solo le variabili obbligate dalle clausole e poi si controllano le clausole negative, in tempo lineare.
Schema della dimostrazione
Idea: si parte con tutte le variabili false e si rende vera una variabile solo quando una clausola obbliga a farlo. Le variabili rese vere lo sono in ogni assegnazione che soddisfa la formula; quindi se così la formula non è soddisfatta, non lo è in nessun modo.
- Forma delle clausole. Con al più un letterale positivo, una clausola di Horn è di uno di due tipi: , cioè l'implicazione (con è il fatto " vera"); oppure , tutta negativa: "le non sono tutte vere".
- Algoritmo. Poni tutte le variabili false. Finché esiste un'implicazione con tutte le vere e falsa, rendi vera. Alla fine controlla le clausole negative: se sono tutte vere rispondi "soddisfacibile" (con l'assegnazione trovata), altrimenti "insoddisfacibile".
- Termina. Ogni giro rende vera una variabile nuova e nessuna torna falsa: al più giri, con variabili.
- Invariante. Ogni variabile resa vera è vera in ogni assegnazione che soddisfa . Per induzione sui giri: diventa vera solo quando sono già vere, e per induzione lo sono in ogni assegnazione che soddisfa ; allora quella clausola obbliga anche .
- Correttezza. Se alla fine le clausole negative sono vere, l'assegnazione soddisfa tutto: le implicazioni perché il ciclo si è fermato (nessuna è violata), le negative per il controllo. Se invece una clausola negativa è falsa, le sue sono tutte vere e, per l'invariante, sono vere in ogni assegnazione che soddisfa : quella clausola sarebbe sempre falsa, quindi nessuna assegnazione soddisfa .
- Tempo. Così com'è, l'algoritmo fa al più scansioni della formula: tempo , polinomiale. Per il tempo lineare si tiene, per ogni clausola, un contatore delle premesse ancora false e, per ogni variabile, l'elenco delle clausole in cui è premessa: quando una variabile diventa vera si aggiornano solo quelle clausole, e ogni letterale viene guardato un numero costante di volte.
Quindi (anzi si risolve in tempo lineare).
Classi
Problemi
Dove: dispensa cap. 12, p. 39; appunti Lez. 8
Capitolo 13 · Problemi in NP
proposizioneProposizione 9.1 (certificati succinti)
chiesto in 4 domandedimostrato nel corso se e solo se esiste una relazione decidibile in tempo polinomiale e polinomialmente bilanciata () tale che .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione 9.1 (certificati succinti)
Intuizione
Il certificato è la registrazione di una computazione che accetta: è corto e si controlla in tempo polinomiale.
All'esame
Serve a dimostrare che un problema sta in NP ("indovina e verifica") e a scrivere un certificato succinto negli esercizi.
Da scrivere all'esame
Sta in NP per la Proposizione 9.1: ha un certificato di lunghezza polinomiale che si verifica in tempo polinomiale (indovina e verifica).
Dimostrazione
Idea: "indovina e verifica". Se ogni ha un certificato corto e controllabile in fretta, una MdT nondeterministica lo indovina e lo controlla. Viceversa, per una macchina NP il certificato è la registrazione di una sua computazione che accetta.
- Termini. è un insieme di coppie di stringhe . È decidibile in tempo polinomiale se una MdT deterministica, data , decide in tempo polinomiale se . È polinomialmente bilanciata se implica per una costante : il certificato è corto rispetto a .
- () Dalla relazione alla macchina. Data , la MdT nondeterministica scrive, scegliendo un simbolo alla volta, una stringa lunga al più (ogni ramo scrive una diversa). Poi esegue in modo deterministico l'algoritmo polinomiale su e accetta se .
- Correttezza: un ramo accetta esiste con . Tempo: passi per scrivere più un polinomio in per verificarla, quindi polinomiale. Perciò .
- () Dalla macchina alla relazione. Sia una MdT nondeterministica che decide con budget di tempo . Definiamo se e solo se codifica una computazione di su che accetta (la sequenza delle configurazioni).
- è bilanciata: la computazione ha al più passi e ogni configurazione è lunga (in passi non si usano più celle), quindi è polinomiale in .
- è decidibile in tempo polinomiale: si controlla che la prima configurazione sia quella iniziale su , che ogni configurazione segua dalla precedente con una mossa di (un controllo locale) e che l'ultima abbia stato "yes". Tutto in tempo lineare in .
- Infine ha una computazione che accetta esiste con , cioè .
Negli esercizi: per mostrare che un problema sta in NP basta dire qual è il certificato , perché è lungo al più polinomiale e come si controlla in tempo polinomiale.
Classi
Dove: dispensa cap. 13, p. 40; appunti Lez. 8
teoremaMAX2SAT è NP-completo
per l'oraledimostrato nel corsoDato un insieme di clausole con 2 letterali e un intero , decidere se si possono soddisfare almeno clausole è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
MAX2SAT è NP-completo
Intuizione
Ogni clausola di 3SAT diventa un gruppo di 10 clausole di 2 letterali: se ne soddisfano al più 7, e 7 esattamente quando la clausola originale è vera (obiettivo ).
All'esame
Mostra che 2-SAT è facile ma la sua versione di massimizzazione è difficile.
Da scrivere all'esame
MAX2SAT è NP-completo (riduzione da 3SAT: 10 clausole per ogni clausola, obiettivo ), anche se .
Dimostrazione
Idea: ogni clausola di 3SAT diventa un gruppo di 10 clausole con 2 letterali; in un gruppo se ne possono soddisfare al più 7, ed esattamente 7 solo quando la clausola originale è vera. Con obiettivo , raggiungere equivale a soddisfare tutta la formula.
- . Certificato: un'assegnazione. Si contano le clausole soddisfatte e si confronta con , in tempo polinomiale.
- Il gruppo. Le dieci clausole sono: ; ; . Sono simmetriche in : conta solo quante di queste tre sono vere. Contiamo le clausole soddisfatte per riga (prima + seconda + terza), scegliendo al meglio:
- tutte vere: con vera (con falsa 6);
- due vere: con vera , con falsa ;
- una vera: con falsa (con vera 6);
- nessuna vera: con falsa (con vera 4).
- Riduzione. Data un'istanza di 3SAT con clausole ( letterali), per ogni aggiungiamo a il gruppo con al posto di e una variabile nuova , propria di , al posto di . ha clausole; l'obiettivo è .
- Se è soddisfacibile, si raggiunge . Prendiamo un'assegnazione che soddisfa : in ogni almeno un letterale è vero, quindi scegliendo come nel passo 2 ogni gruppo dà 7 clausole: in totale.
- Se si raggiunge , è soddisfacibile. Ogni gruppo dà al più 7 clausole e ci sono gruppi; per arrivare a ogni gruppo deve darne esattamente 7. Un gruppo la cui fosse falsa ne darebbe al più 6; quindi ogni è vera e la stessa assegnazione soddisfa .
- Spazio logaritmico. I gruppi si scrivono uno alla volta con un contatore : bit.
3SAT è NP-completo e si riduce a MAX2SAT; con il passo 1, MAX2SAT è NP-completo. Contrasto: soddisfare tutte le clausole con 2 letterali (2-SAT) è in P, massimizzarne il numero è NP-completo.
Classi
Problemi
Dove: dispensa cap. 13, p. 41; appunti Lez. 8
teoremaINDEPENDENT SET è NP-completo
per l'oraledimostrato nel corsoDato un grafo e un intero , decidere se ha un insieme indipendente di nodi è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
INDEPENDENT SET è NP-completo
Intuizione
Riduzione da 3SAT: un triangolo per ogni clausola e un arco tra letterali opposti; un insieme indipendente di nodi sceglie un letterale vero per clausola.
All'esame
È il punto di partenza per CLIQUE e NODE COVER.
Da scrivere all'esame
INDEPENDENT SET è NP-completo (riduzione da 3SAT: un triangolo per clausola, archi tra letterali opposti, ).
Dimostrazione
Idea: si riduce 3SAT. Ogni clausola diventa un triangolo (un nodo per letterale) e i letterali opposti si collegano con un arco: un insieme indipendente con un nodo per triangolo sceglie, senza contraddizioni, un letterale vero per clausola.
- . Il certificato è l'insieme di nodi. Si controlla in tempo polinomiale che abbia nodi e che nessuna coppia di nodi di sia collegata da un arco (al più controlli).
- Costruzione. Sia (fi) una formula di 3SAT con clausole , dove e ogni è una variabile o una variabile negata. Si costruisce il grafo ( è l'insieme dei nodi, quello degli archi) con un nodo per ogni letterale di ogni clausola, quindi nodi, e due tipi di archi: (a) i tre nodi della stessa clausola formano un triangolo; (b) due nodi di clausole diverse sono collegati se i loro letterali sono opposti ( e ). L'obiettivo è . La costruzione confronta solo coppie di letterali: spazio logaritmico.
- Osservazione chiave. In un triangolo ogni nodo è collegato agli altri due, quindi un insieme indipendente contiene al più un nodo per triangolo. Ci sono triangoli, quindi un insieme indipendente di nodi ne prende esattamente uno da ciascun triangolo.
- Se esiste indipendente con nodi, è soddisfacibile. Si rendono veri i letterali che etichettano i nodi di (le variabili rimaste libere prendono un valore qualsiasi). L'assegnazione è coerente: due letterali opposti sono collegati da un arco di tipo (b), quindi non stanno entrambi in . Soddisfa : per il passo 3, ha un nodo in ogni triangolo, cioè un letterale vero in ogni clausola.
- Se è soddisfacibile, esiste indipendente con nodi. Si fissa un'assegnazione che soddisfa e in ogni clausola si sceglie un letterale vero; si prende il nodo corrispondente. I nodi scelti sono , uno per triangolo, quindi tra loro non ci sono archi di tipo (a); non ci sono nemmeno archi di tipo (b), perché sono tutti letterali veri e due letterali opposti non sono mai veri insieme.
Quindi , e INDEPENDENT SET è NP-completo.
Classi
Problemi
Dove: dispensa cap. 13, p. 42; appunti Lez. 8
corollarioCorollario: CLIQUE e NODE COVER sono NP-completi
★ chiesto in 8 domandedimostrato nel corsoCLIQUE e NODE COVER sono NP-completi.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario: CLIQUE e NODE COVER sono NP-completi
Intuizione
Una cricca di è un insieme indipendente del grafo complementare; è indipendente se e solo se è una copertura dei nodi.
All'esame
CLIQUE è il problema NP-completo più usato negli esercizi sulle riduzioni.
Da scrivere all'esame
CLIQUE e NODE COVER sono NP-completi: una cricca di è un insieme indipendente del grafo complementare, e è indipendente se e solo se è una copertura dei nodi.
Dimostrazione
Idea: entrambi sono INDEPENDENT SET “travestito”, quindi basta riscrivere l'istanza.
- Appartenenza a NP. Per CLIQUE il certificato è un insieme di nodi: si controlla che ogni coppia sia collegata da un arco. Per NODE COVER il certificato è un insieme di al più nodi ( è il budget): si controlla che ogni arco abbia almeno un estremo in . Entrambi i controlli sono polinomiali.
- Grafo complementare. Dato (nodi , archi ), il complementare ha gli stessi nodi e ha l'arco esattamente quando non ce l'ha. Si costruisce in spazio logaritmico.
- INDEPENDENT SET si riduce a CLIQUE. La riduzione manda in . Infatti è indipendente in nessuna coppia di nodi di è un arco di ogni coppia di nodi di è un arco di è una cricca di . Quindi ha un insieme indipendente di nodi se e solo se ha una cricca di nodi.
- Lemma per NODE COVER. è indipendente è una copertura dei nodi (ogni arco ha un estremo in ). Infatti un arco resta scoperto da esattamente quando e stanno entrambi in , cioè quando non è indipendente.
- INDEPENDENT SET si riduce a NODE COVER. Con nodi, la riduzione manda in con (se la risposta è NO e si produce un'istanza NO fissa). Se è indipendente con nodi, è una copertura con nodi (passo 4). Viceversa, se è una copertura con al più nodi, le si aggiungono nodi fino ad averne esattamente (aggiungere nodi non scopre nessun arco); allora ha nodi ed è indipendente (passo 4).
INDEPENDENT SET è NP-completo e si riduce a entrambi i problemi, che stanno in NP: quindi CLIQUE e NODE COVER sono NP-completi.
Dove serve nelle tracce
F02 n. 3 · F04 n. 1 · F04 n. 2 · F07 n. 6 · L18 n. 6 · G20v4 n. 7 · ND n. 6 · SP n. 4
Classi
Problemi
Dove: dispensa cap. 13, p. 44; appunti Lez. 8
teoremaHAMILTON PATH è NP-completo
chiesto in 3 domandeDecidere se un grafo ha un cammino che passa per ogni nodo esattamente una volta è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
HAMILTON PATH è NP-completo
Intuizione
Sta in NP perché un cammino proposto si controlla in tempo lineare; la difficoltà si mostra riducendo 3SAT.
All'esame
Problema NP-completo ricorrente; il suo complemento è coNP-completo.
Da scrivere all'esame
HAMILTON PATH è NP-completo (in NP perché un cammino proposto si verifica in tempo lineare, NP-difficile per riduzione da 3SAT), quindi il suo complemento è coNP-completo.
Schema della dimostrazione
Idea: che HAMILTON PATH stia in NP è immediato (si controlla il cammino proposto). Per la difficoltà, omessa nel corso, si riduce 3SAT (schema dal Papadimitriou): una catena di gadget sceglie i valori delle variabili, un triangolo per clausola controlla che la clausola sia vera, e dei gadget “XOR” rendono coerenti le due parti.
Attenzione alla definizione: un cammino hamiltoniano visita ogni nodo esattamente una volta e non deve tornare al nodo di partenza.
- . Il certificato è una sequenza di nodi ( è il numero di nodi del grafo). Si controlla in tempo lineare che ogni nodo compaia esattamente una volta e che due nodi consecutivi siano collegati da un arco.
- Gadget di scelta. Per ogni variabile si mettono due nodi uniti da due collegamenti alternativi: uno significa “ vera”, l'altro “ falsa”. I gadget sono messi in fila in una catena: un cammino hamiltoniano che percorre la catena usa, per ogni variabile, esattamente uno dei due collegamenti, cioè sceglie un valore.
- Gadget XOR. Esiste un piccolo sottografo che lega due archi in modo che ogni cammino hamiltoniano ne attraversi esattamente uno. Serve a collegare le scelte delle variabili alle clausole.
- Gadget di clausola. Per ogni clausola si mette un triangolo, con un lato per ciascuno dei suoi tre letterali. Il lato del letterale è legato con un XOR al collegamento “ falsa” della catena (per il letterale , al collegamento “ vera”). Così un lato è attraversato esattamente quando il suo letterale è falso.
- Chiusura. I nodi di tutti i triangoli e l'ultimo nodo della catena sono collegati tutti tra loro, e si aggiungono due nodi di estremità che obbligano il cammino a partire dall'inizio della catena e a finire nella zona dei triangoli. Il grafo ha dimensione polinomiale in (la formula) e si costruisce in spazio logaritmico.
- Se c'è un cammino hamiltoniano, è soddisfacibile. Percorrendo la catena il cammino fissa un'assegnazione (passo 2). Non può attraversare tutti e tre i lati di un triangolo, perché chiuderebbe un ciclo e un cammino non ne contiene. Quindi in ogni triangolo almeno un lato non è attraversato, cioè (passo 4) almeno un letterale della clausola è vero.
- Se è soddisfacibile, c'è un cammino hamiltoniano. Si percorre la catena scegliendo i collegamenti secondo l'assegnazione; gli XOR fissano quali lati dei triangoli vanno attraversati, e in ogni triangolo almeno un lato resta libero (letterale vero). Si visitano allora i nodi di ogni triangolo usando i lati attraversati e gli archi aggiunti al passo 5 per passare al triangolo successivo, fino al nodo finale.
Quindi 3SAT si riduce a HAMILTON PATH, che è NP-completo.
Classi
Problemi
Dove: dispensa cap. 13, p. 44; appunti Lez. 8. La dispensa mostra solo l'appartenenza a NP; per la difficoltà dice soltanto "si riduce 3SAT".
teoremaTSP(D) è NP-completo
chiesto in 5 domandedimostrato nel corsoData una matrice delle distanze tra città e un budget , decidere se esiste un giro di tutte le città di costo al più è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
TSP(D) è NP-completo
Intuizione
Ogni nodo del grafo diventa una città, a distanza 1 se c'è l'arco e 2 se non c'è: un giro di costo esiste se e solo se il grafo ha un ciclo hamiltoniano.
All'esame
Problema NP-completo ricorrente; servono solo distanze 1 e 2, quindi è NP-completo in senso forte.
Da scrivere all'esame
TSP(D) è NP-completo, anche in senso forte: HAMILTON CYCLE vi si riduce con distanza 1 sugli archi, 2 altrove e budget .
Dimostrazione
Idea: si riduce HAMILTON CYCLE (il grafo ha un ciclo che passa per ogni nodo una volta e torna all'inizio?) a TSP(D). I nodi diventano città, a distanza 1 se c'è l'arco e 2 se non c'è, con budget : un giro costa solo se usa esclusivamente archi del grafo.
- . Il certificato è un giro, cioè un ordine delle città. Si controlla che ogni città compaia una volta e che la somma delle distanze (compreso il ritorno alla prima città) sia . Tempo polinomiale.
- HAMILTON CYCLE è NP-completo. Sta in NP come HAMILTON PATH (si controlla il ciclo proposto). È NP-difficile perché HAMILTON PATH vi si riduce: dato si aggiunge un nodo nuovo collegato a tutti i nodi. Se ha un cammino hamiltoniano , allora è un ciclo hamiltoniano del nuovo grafo. Viceversa, togliendo da un ciclo hamiltoniano del nuovo grafo resta un cammino che tocca tutti i nodi di usando solo archi di .
- Costruzione. Dato con nodi, si creano città e si pone (distanza tra le città e ) se è un arco di , altrimenti; il budget è . Ogni casella della matrice dipende da un solo arco: la riduzione si calcola in spazio logaritmico.
- Ogni giro costa almeno . Un giro di città ha esattamente tratte, ognuna di costo almeno 1. Quindi costo costo ogni tratta costa 1 ogni tratta è un arco di .
- Correttezza. Se ha un ciclo hamiltoniano, percorrerlo come giro usa solo archi: costo . Se esiste un giro di costo , per il passo 4 tutte le sue tratte sono archi di , quindi quel giro è un ciclo hamiltoniano di .
Quindi TSP(D) è NP-completo. La riduzione usa solo le distanze 1 e 2, cioè numeri piccoli: TSP(D) è NP-completo anche in senso forte.
Classi
Problemi
Dove: dispensa cap. 13, p. 44; appunti Lez. 8
teorema3-COLORING è NP-completo ()
★ chiesto in 10 domandedimostrato nel corsoDecidere se un grafo si colora con 3 colori senza nodi adiacenti dello stesso colore è NP-completo; con 2 colori il problema è in P.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
3-COLORING è NP-completo ()
Intuizione
Riduzione da 3SAT con due gadget: uno codifica il valore vero/falso dei letterali, l'altro l'OR di una clausola.
All'esame
Esempio classico del salto da 2 a 3: 2-COLORING in P, 3-COLORING NP-completo.
Da scrivere all'esame
3-COLORING è NP-completo (riduzione da 3SAT con un gadget per i valori di verità e un gadget OR), mentre 2-COLORING è in P.
Dimostrazione
Idea: 2-COLORING si risolve colorando “a cascata”. Per 3-COLORING si riduce 3SAT con due gadget: un triangolo che dà un nome ai tre colori (Vero, Falso, Neutro) e obbliga ogni letterale a essere o , e un gadget OR la cui uscita può essere solo se uno degli ingressi è .
- (il corso lo afferma senza prova). In ogni componente connessa si colora un nodo; i suoi vicini sono obbligati ad avere l'altro colore, i loro vicini il primo, e così via (visita in ampiezza). Il grafo è 2-colorabile se e solo se questa colorazione obbligata non crea conflitti: tempo lineare.
- . Il certificato è un colore per ogni nodo; si controlla che ogni arco abbia estremi di colori diversi. Tempo polinomiale.
- 1° gadget: valori di verità. Si mette un triangolo di nodi (vero, falso, neutro): in ogni 3-colorazione hanno tre colori diversi, e chiamiamo i colori con i loro nomi. Per ogni variabile si mettono due nodi e , collegati tra loro e al nodo . Allora e non sono e sono diversi tra loro: uno è e l'altro . Colorare questi nodi equivale a scegliere un'assegnazione di verità.
- 2° gadget: OR. Dati due nodi di ingresso e , si aggiunge un triangolo con collegato a e collegato a ; è l'uscita. (i) Se e sono entrambi , allora e non sono , quindi sono e in qualche ordine, e deve essere . (ii) Se o è , il gadget si può colorare con : per esempio, se si pone , , (se invece , simmetricamente , ).
- Clausole. Per la clausola si mettono due OR in cascata: il primo ha ingressi e ; il secondo ha ingressi l'uscita del primo e . L'uscita finale è collegata ai nodi e , quindi deve essere . Il grafo ha dimensione lineare nella formula .
- Se il grafo è 3-colorabile, è soddisfacibile. Si prende l'assegnazione letta al passo 3. Se una clausola avesse i tre letterali , per (i) l'uscita del primo OR sarebbe e, di nuovo per (i), anche l'uscita finale: impossibile, perché è . Quindi ogni clausola ha un letterale vero.
- Se è soddisfacibile, il grafo è 3-colorabile. Si colorano e i letterali secondo l'assegnazione. In ogni clausola c'è un letterale . Se è o , per (ii) il primo OR ha uscita e allora anche il secondo ha uscita . Altrimenti e sono , il primo OR si colora con uscita (come in (i)) e il secondo ha uscita per (ii), perché .
Quindi 3SAT si riduce a 3-COLORING, che è NP-completo.
Dove serve nelle tracce
F04 n. 3 · F12 n. 2 · F14 n. 1 · G20v1 n. 4 · MA23 n. 2 · MA23 n. 7 · SE23 n. 6 · LU24 n. 2 · ND n. 1 · ND n. 4
Dove: dispensa cap. 13, p. 44; appunti Lez. 8. Che 2-COLORING sia in P è solo affermato, senza prova.
teoremaTRIPARTITE MATCHING è NP-completo
Dati tre insiemi , , di elementi e una relazione , decidere se esistono terne di senza componenti in comune è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
TRIPARTITE MATCHING è NP-completo
Intuizione
Con le coppie (matching bipartito) il problema è facile; con le terne diventa difficile.
All'esame
È il punto di partenza per i problemi su insiemi.
Da scrivere all'esame
TRIPARTITE MATCHING è NP-completo (riduzione da 3SAT, prova omessa nel corso), quindi lo sono anche le sue generalizzazioni come EXACT COVER BY 3-SETS.
Schema della dimostrazione
Idea: che il problema stia in NP è immediato. Per la difficoltà, omessa nel corso, si riduce 3SAT (schema dal Papadimitriou): ogni variabile diventa un “anello” di terne che si completa solo in due modi (vero o falso); ogni clausola diventa una coppia ragazzo-ragazza che trova casa solo se un suo letterale è vero; alcune coppie “di raccolta” occupano le case avanzate.
- In NP. Il certificato sono terne: si controlla che stiano in e che non abbiano componenti in comune.
- Preparazione. Sia una formula 3SAT con clausole di tre letterali: ci sono occorrenze di letterali. Ogni occorrenza della variabile riceve due case: una che resta libera quando è vera e una che resta libera quando è falsa.
- Gadget della variabile . Se compare volte, si mettono ragazzi , ragazze e le sue case ad anello, con le terne e , dove . Questi ragazzi e ragazze non compaiono altrove. Se usa la prima terna, può andare solo con , che deve usare anche lui la prima terna, e così via lungo l'anello; lo stesso vale per la seconda terna. Quindi ci sono solo due modi di sistemare il gadget: occupare tutte le case dispari (restano libere le pari: “ vera”) oppure tutte le pari (restano libere le dispari: “ falsa”).
- Gadget di clausola. Per ogni clausola si aggiungono un ragazzo e una ragazza, con tre terne: una per ogni letterale, verso la casa della sua occorrenza che è libera quando il letterale è vero (per una casa pari, per una dispari). La coppia trova casa solo se almeno un letterale è vero.
- Raccolta. Le case sono ; i gadget delle variabili ne occupano e le clausole , quindi ne avanzano . Si aggiungono coppie “di raccolta”, ognuna con una terna verso ogni casa. Ora ragazzi, ragazze e case sono tutti . La costruzione è polinomiale.
- Se è soddisfacibile, c'è un matching. Si sistema ogni gadget secondo l'assegnazione; ogni clausola prende la casa libera di un suo letterale vero (clausole diverse usano occorrenze diverse, quindi case diverse); le coppie di raccolta prendono le case rimaste.
- Se c'è un matching, è soddisfacibile. Dal modo in cui è sistemato ogni gadget si legge il valore della variabile (passo 3). Ogni coppia di clausola ha una casa, e quella casa è libera solo se il letterale corrispondente è vero: ogni clausola è soddisfatta.
Classi
Dove: dispensa cap. 13, p. 47; appunti Lez. 8
corollarioCorollario: EXACT COVER BY 3-SETS, SET COVERING e SET PACKING sono NP-completi
per l'oraledimostrato nel corsoEXACT COVER BY 3-SETS, SET COVERING e SET PACKING sono NP-completi.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario: EXACT COVER BY 3-SETS, SET COVERING e SET PACKING sono NP-completi
Intuizione
Sono tutti generalizzazioni di TRIPARTITE MATCHING: se un caso particolare è difficile, lo è anche il problema generale.
Da scrivere all'esame
EXACT COVER BY 3-SETS, SET COVERING e SET PACKING sono NP-completi perché generalizzano TRIPARTITE MATCHING, che è NP-completo.
Dimostrazione
Idea: TRIPARTITE MATCHING è un caso particolare di EXACT COVER BY 3-SETS, che a sua volta è un caso particolare sia di SET COVERING sia di SET PACKING. Se un caso particolare è NP-completo, lo è anche il problema più generale: la riduzione consiste solo nel riscrivere l'istanza.
- Tutti in NP. Il certificato è la lista degli insiemi scelti; si controlla in tempo polinomiale che siano disgiunti e/o che la loro unione sia l'universo , e che il loro numero rispetti il budget o l'obiettivo .
- TRIPARTITE MATCHING → EXACT COVER BY 3-SETS. Data l'istanza si pone (elementi tutti distinti, quindi , cioè ) e la famiglia delle terne di , ognuna vista come insieme di 3 elementi. terne senza componenti in comune sono insiemi disgiunti di 3 elementi, quindi coprono elementi, cioè tutto ; viceversa una copertura esatta è fatta di terne disgiunte. Quindi matching copertura esatta.
- EXACT COVER BY 3-SETS → SET COVERING. Stessa famiglia, budget . Una copertura esatta usa insiemi. Viceversa, se al più insiemi di 3 elementi coprono , che ha elementi, devono essere esattamente e disgiunti: altrimenti la loro unione avrebbe meno di elementi.
- EXACT COVER BY 3-SETS → SET PACKING. Stessa famiglia, obiettivo . Una copertura esatta dà insiemi disgiunti. Viceversa, insiemi disgiunti di 3 elementi contengono in tutto elementi, quindi la loro unione è tutto : è una copertura esatta.
Le trasformazioni si calcolano in spazio logaritmico e TRIPARTITE MATCHING è NP-completo: quindi i tre problemi sono NP-completi.
Classi
Dove: dispensa cap. 13, p. 47; appunti Lez. 8
proposizioneINTEGER PROGRAMMING è NP-completo
Decidere se un sistema di disuguaglianze lineari a coefficienti interi ha una soluzione intera è NP-completo; senza il vincolo di interi (LINEAR PROGRAMMING) il problema è in P.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
INTEGER PROGRAMMING è NP-completo
Intuizione
Tutti i problemi visti si scrivono come disuguaglianze lineari sugli interi (per esempio SET COVERING); la parte difficile è dimostrare che il problema sta in NP.
Da scrivere all'esame
INTEGER PROGRAMMING è NP-completo (per esempio SET COVERING si scrive come disuguaglianze su variabili 0/1), mentre LINEAR PROGRAMMING è in P.
Schema della dimostrazione
Idea: la difficoltà è facile, perché SET COVERING (come quasi tutti i problemi visti) si scrive come sistema di disuguaglianze su variabili intere 0/1. La parte difficile, omessa nel corso, è l'appartenenza a NP: bisogna garantire che, se c'è una soluzione intera, ce ne sia una abbastanza “corta” da fare da certificato.
- Riduzione da SET COVERING. Data la famiglia di sottoinsiemi di e il budget , si usa una variabile per ogni insieme con : sugli interi vale 1 se è scelto e 0 altrimenti. Per ogni elemento di si scrive la somma delle con ( è coperto), e poi (al più insiemi). In forma compatta , dove ha una riga per ogni elemento e una colonna per ogni insieme (la colonna è il vettore di bit di ).
- Correttezza. Le soluzioni intere del sistema sono esattamente i vettori 0/1 che indicano al più insiemi con unione . Quindi il sistema ha soluzione intera l'istanza di SET COVERING è SÌ. Il sistema si scrive in spazio logaritmico: INTEGER PROGRAMMING è NP-difficile.
- Perché l'appartenenza a NP non è ovvia. L'idea naturale è “indovina una soluzione intera e verificala”. Ma in generale le variabili non sono limitate a 0/1: a priori le soluzioni potrebbero contenere solo numeri enormi, con più cifre di quante ne possa avere un certificato polinomiale.
- Il risultato che serve (note del libro). Se un sistema di disuguaglianze lineari a coefficienti interi ha una soluzione intera, ne ha anche una le cui componenti sono al più esponenziali nella dimensione dell'istanza (dipendono dal numero di variabili, di vincoli e dal coefficiente più grande). Il motivo è che si può partire dai “vertici” del sistema, che per la regola di Cramer sono rapporti di determinanti e hanno un numero polinomiale di cifre.
- Conclusione. Il certificato è quella soluzione piccola: ha un numero polinomiale di bit e si verifica sostituendola nelle disuguaglianze in tempo polinomiale. Quindi ed è NP-completo.
- . Senza il vincolo di interi il problema si risolve in tempo polinomiale (algoritmo dell'ellissoide); il corso lo afferma soltanto.
Problemi
Dove: dispensa cap. 13, p. 47; appunti Lez. 8. La dispensa mostra solo la difficoltà; l'appartenenza a NP è rimandata alle note del libro.
teoremaKNAPSACK è NP-completo
per l'oraledimostrato nel corsoDati oggetti con peso e valore interi, un limite di peso e un obiettivo , decidere se si possono scegliere oggetti di peso totale e valore è NP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
KNAPSACK è NP-completo
Intuizione
Riduzione da EXACT COVER BY 3-SETS: ogni insieme diventa un numero scritto in base , così le somme non hanno riporti; servono però numeri esponenzialmente grandi.
All'esame
È l'unico NP-completo del capitolo che non lo è in senso forte.
Da scrivere all'esame
KNAPSACK è NP-completo (riduzione da EXACT COVER BY 3-SETS con numeri in base ), ma non in senso forte: la riduzione crea numeri di valore esponenziale.
Dimostrazione
Idea: basta mostrare NP-completo il caso particolare con valore = peso e , cioè trovare dei numeri con somma esattamente . Lo si fa riducendo EXACT COVER BY 3-SETS: ogni insieme diventa un numero le cui cifre dicono quali elementi contiene, scritto in base perché nelle somme non ci siano riporti.
- . Il certificato è l'insieme degli oggetti scelti; si controlla in tempo polinomiale che la somma dei pesi sia e quella dei valori sia .
- Caso particolare. Se per ogni e , le due condizioni diventano “somma ” e “somma ”, cioè somma esattamente . Questo caso è un'istanza di KNAPSACK: se è NP-difficile, lo è anche KNAPSACK.
- Costruzione. Data un'istanza di EXACT COVER BY 3-SETS con insiemi su , si vede ogni come un vettore di bit (il bit vale 1 se ) e lo si legge come numero in base : . Si pone , cioè il numero con cifre tutte uguali a 1 (l'intero universo ).
- Perché la base . In base 2 ci sarebbero riporti: , anche se , , non sono disgiunti. In base , sommando alcuni degli numeri, la cifra in posizione vale quanti insiemi scelti contengono : al più , quindi meno della base , e non c'è mai riporto.
- Correttezza. Senza riporti, la somma dei numeri scelti è se e solo se ogni cifra vale esattamente 1, cioè se e solo se ogni elemento di sta in esattamente uno degli insiemi scelti: è proprio una copertura esatta.
- Dimensione. Ogni numero ha cifre in base , quindi bit: la riduzione è polinomiale (anzi in spazio logaritmico), anche se il valore dei numeri è esponenziale.
Quindi KNAPSACK è NP-completo. I numeri costruiti sono esponenziali: per questo la prova non dice nulla sul caso con numeri piccoli, che infatti si risolve con l'algoritmo pseudopolinomiale .
Classi
Problemi
Dove: dispensa cap. 13, p. 48; appunti Lez. 8
proposizioneProposizione (KNAPSACK in tempo )
per l'oraledimostrato nel corsoOgni istanza di KNAPSACK si risolve in tempo , dove è il numero di oggetti e il limite di peso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (KNAPSACK in tempo )
Intuizione
Programmazione dinamica su una tabella ; ma può essere esponenziale nella lunghezza dell'input (circa ), quindi l'algoritmo è solo pseudopolinomiale.
All'esame
Non dimostra : il tempo è polinomiale nel valore dei numeri, non nella loro lunghezza.
Da scrivere all'esame
KNAPSACK si risolve in tempo , ma è un algoritmo pseudopolinomiale ( è esponenziale nella lunghezza dell'input), quindi non implica .
Dimostrazione
Idea: programmazione dinamica. Si riempie una tabella che, per ogni numero di oggetti considerati e ogni limite di peso, ricorda il massimo valore ottenibile; ogni casella costa un numero costante di operazioni.
- Tabella. Per e , è il massimo valore ottenibile scegliendo tra i primi oggetti con peso totale al più . Le caselle sono , cioè .
- Inizio. per ogni : senza oggetti il valore è 0.
- Passo. , dove il secondo termine si usa solo se . Vale perché una scelta ottima tra i primi oggetti o non prende l'oggetto , e allora è una scelta ottima tra i primi con limite ; oppure lo prende, e allora il resto è una scelta tra i primi con il peso rimasto , e conviene che sia ottima.
- Ordine e costo. Si calcolano le caselle per crescente: ognuna usa due caselle della colonna precedente, già pronte, e un numero costante di operazioni. Tempo totale .
- Risposta. L'istanza è SÌ se e solo se . (La dispensa parla di peso “esattamente ” e guarda se qualche casella è ; partendo da per ogni si ottiene di fatto la versione “al più ”, e la risposta è la stessa.)
- Perché non dimostra . si scrive in binario con circa bit, quindi la lunghezza dell'input è circa . Il tempo è polinomiale nel valore ma esponenziale nella sua lunghezza (): l'algoritmo è solo pseudopolinomiale.
Classi
Problemi
Dove: dispensa cap. 13, p. 49; appunti Lez. 8
proposizioneNP-completezza in senso forte
Un problema che resta NP-completo anche quando i numeri nell'input hanno valore polinomiale (strongly NP-complete) non ha algoritmi pseudopolinomiali, a meno che . Tutti gli NP-completi del capitolo lo sono in senso forte, tranne KNAPSACK.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
NP-completezza in senso forte
Intuizione
Se i numeri sono piccoli, un algoritmo pseudopolinomiale diventa polinomiale.
Da scrivere all'esame
Un problema NP-completo in senso forte non ha algoritmi pseudopolinomiali a meno che ; tutti gli NP-completi visti lo sono, tranne KNAPSACK.
Schema della dimostrazione
Idea: se i numeri di un'istanza hanno valore polinomiale nella sua lunghezza, un algoritmo pseudopolinomiale, che è polinomiale nel valore dei numeri, diventa un algoritmo polinomiale vero e proprio.
- Definizioni. Un algoritmo è pseudopolinomiale se impiega tempo , con polinomio, dove è la lunghezza dell'istanza e il valore del numero più grande che contiene. Un problema è NP-completo in senso forte se, per un polinomio , resta NP-completo la sua restrizione alle istanze con numeri di valore al più .
- L'algoritmo sulla restrizione. Supponiamo che abbia un algoritmo pseudopolinomiale . Per decidere si controlla prima che i numeri siano (tempo polinomiale), poi si esegue . Su queste istanze , quindi impiega tempo , che è un polinomio in . Dunque .
- Conseguenza. è NP-completo, quindi ogni problema di NP vi si riduce; P è chiusa rispetto alle riduzioni, quindi , cioè .
- Gli NP-completi del capitolo sono forti. In SAT, CLIQUE, HAMILTON PATH, TRIPARTITE MATCHING ecc. i numeri sono solo nomi di nodi o indici di variabili, di valore al più la lunghezza dell'istanza; TSP(D) è NP-completo già con distanze 1 e 2. Le loro riduzioni producono solo numeri piccoli, quindi restano NP-completi ristretti a numeri polinomiali.
- L'eccezione KNAPSACK. La sua riduzione da EXACT COVER BY 3-SETS crea numeri di valore esponenziale, e KNAPSACK ha l'algoritmo pseudopolinomiale . Per i passi 2-3, se fosse NP-completo in senso forte avremmo .
Problemi
Dove: dispensa cap. 13, p. 50; appunti Lez. 8
Capitolo 14 · coNP
teoremaVALIDITY è coNP-completo
chiesto in 7 domandedimostrato nel corsoVALIDITY (la formula è vera per ogni assegnazione?) è coNP-completo; lo è anche HAMILTON PATH COMPLEMENT (il grafo non ha cammini hamiltoniani?).
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
VALIDITY è coNP-completo
Intuizione
Se , il suo complemento si riduce a SAT con una ; allora riduce a VALIDITY.
All'esame
È il coNP-completo di riferimento: per esempio una riduzione da SAT a VALIDITY esiste solo se .
Da scrivere all'esame
VALIDITY è coNP-completo (se riduce a SAT, riduce a VALIDITY), quindi una riduzione da SAT a VALIDITY implicherebbe .
Dimostrazione
Idea: VALIDITY è il “negativo” di SAT: una formula è valida se e solo se la sua negazione è insoddisfacibile. Quindi una riduzione verso SAT, seguita da una negazione, diventa una riduzione verso VALIDITY.
- . Il suo complemento (le formule non valide) sta in NP: il certificato è un'assegnazione che rende falsa la formula, e si verifica in tempo polinomiale. Una formula valida non ha un tale certificato.
- Partenza. Sia un linguaggio qualsiasi di coNP. Per definizione il suo complemento (le stringhe che non stanno in ) sta in NP. SAT è NP-completo, quindi esiste una riduzione da a SAT: per ogni , è soddisfacibile.
- Nuova riduzione. Si pone : si calcola e si aggiungono una negazione e una coppia di parentesi, sempre in spazio logaritmico.
- Correttezza. non è soddisfacibile ogni assegnazione rende falsa ogni assegnazione rende vera .
- Conclusione per VALIDITY. Ogni si riduce a VALIDITY, che sta in coNP: VALIDITY è coNP-completo.
- HAMILTON PATH COMPLEMENT. Sta in coNP perché il suo complemento, HAMILTON PATH, sta in NP. Se , allora si riduce a HAMILTON PATH (NP-completo) con una riduzione : ha un cammino hamiltoniano. Negando, non ha cammini hamiltoniani: la stessa riduce a HAMILTON PATH COMPLEMENT, che è quindi coNP-completo.
Dove serve nelle tracce
F12 n. 2 · F12 n. 5 · F14 n. 2 · G20v2 n. 3 · LU22 n. 1 · SE23 n. 1 · ND n. 7
Classi
Problemi
Dove: dispensa cap. 14, p. 53; appunti Lez. 8
proposizioneProposizione A (riduzioni e complementi)
per l'oraledimostrato nel corsoSe è una riduzione da a , allora è anche una riduzione dal complemento di al complemento di .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione A (riduzioni e complementi)
Intuizione
equivale a .
All'esame
Strumento per dimostrare le Proposizioni B, C e D.
Da scrivere all'esame
Per la Proposizione A, una riduzione da a è anche una riduzione dal complemento di al complemento di .
Dimostrazione
Idea: la definizione di riduzione è un “se e solo se”, e un “se e solo se” resta vero se si negano entrambi i lati.
- Ipotesi. è una riduzione da a : si calcola in spazio logaritmico e, per ogni stringa , .
- Negazione. Se due affermazioni sono equivalenti, lo sono anche le loro negazioni: .
- Complementi. Il complemento di è l'insieme delle stringhe che non stanno in . Quindi significa , e significa . Il passo 2 diventa .
- Conclusione. è la stessa funzione, quindi si calcola ancora in spazio logaritmico, e soddisfa la condizione per i complementi: è una riduzione da a .
Dove: dispensa cap. 14, p. 53; appunti Lez. 8
proposizioneProposizione B (complemento di un NP-completo)
chiesto in 5 domandedimostrato nel corsoSe è NP-completo, allora il suo complemento è coNP-completo (e viceversa).
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione B (complemento di un NP-completo)
Intuizione
Per la Proposizione A le stesse riduzioni funzionano sui complementi.
All'esame
Dà subito problemi coNP-completi: UNSAT, HAMILTON PATH COMPLEMENT, il complemento di TSP(D) e così via.
Da scrivere all'esame
Per la Proposizione B il complemento di un problema NP-completo è coNP-completo (per esempio UNSAT e HAMILTON PATH COMPLEMENT).
Dimostrazione
Idea: per la Proposizione A le riduzioni verso diventano riduzioni verso il suo complemento ; e i problemi di coNP sono esattamente i complementi dei problemi di NP.
- . è NP-completo, quindi ; per definizione di coNP (i linguaggi il cui complemento sta in NP), .
- Riduzione di partenza. Sia un linguaggio qualsiasi di coNP. Allora il suo complemento sta in NP e, poiché è NP-completo, esiste una riduzione da a .
- Proposizione A. è anche una riduzione dal complemento di al complemento di . Il complemento del complemento è il linguaggio di partenza, quindi riduce a .
- Conclusione. Ogni si riduce a , che sta in coNP: è coNP-completo.
- Viceversa. Se è coNP-completo, lo stesso ragionamento con NP e coNP scambiati (il complemento di un problema di coNP sta in NP) mostra che è NP-completo.
Dove serve nelle tracce
F12 n. 2 · F14 n. 2 · G20v2 n. 3 · LU22 n. 1 · ND n. 7
Dove: dispensa cap. 14, p. 54; appunti Lez. 8
proposizioneProposizione C (chiusura dei complementi)
per l'oraledimostrato nel corsoSe una classe è chiusa rispetto alle riduzioni, anche lo è.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione C (chiusura dei complementi)
Intuizione
Si applica la chiusura di ai complementi, usando la Proposizione A.
All'esame
Per esempio coNP è chiusa rispetto alle riduzioni perché lo è NP.
Da scrivere all'esame
Per la Proposizione C, se una classe è chiusa rispetto alle riduzioni lo è anche (per esempio coNP, perché NP lo è).
Dimostrazione
Idea: si passa ai complementi con la Proposizione A, si usa la chiusura di e si torna indietro.
- Definizione. è chiusa rispetto alle riduzioni se: e si riduce a . Bisogna mostrare lo stesso per : se e è una riduzione da a , allora .
- Passaggio ai complementi. significa, per definizione, che il complemento sta in .
- Proposizione A. è anche una riduzione da (complemento di ) a .
- Chiusura di . , si riduce a e è chiusa, quindi .
- Conclusione. Il complemento di sta in , quindi per definizione : è chiusa rispetto alle riduzioni.
Dove: dispensa cap. 14, p. 54; appunti Lez. 8
proposizioneProposizione D (un -completo in )
★ chiesto in 18 domandedimostrato nel corsoSe è chiusa rispetto alle riduzioni e un problema -completo sta in , allora .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione D (un -completo in )
Intuizione
Tutto si riduce a quel problema, che sta in , chiusa per la Proposizione C: quindi , e per simmetria .
All'esame
Se un problema NP-completo stesse in coNP (o un coNP-completo in NP), allora .
Da scrivere all'esame
Per la Proposizione D, se un problema NP-completo stesse in coNP (o un coNP-completo in NP), allora .
Dimostrazione
Idea: tutto si riduce al problema completo ; poiché sta in , che è chiusa, tutto finisce in . L'inclusione opposta si ottiene passando ai complementi.
- Ipotesi. è chiusa rispetto alle riduzioni, è -completo e . Per la Proposizione C anche è chiusa.
- . Sia . Poiché è -completo, si riduce a . Poiché e è chiusa, .
- , prima parte. Sia , cioè il suo complemento sta in . Poiché è -completo, esiste una riduzione da a ; per la Proposizione A, è anche una riduzione da a .
- , seconda parte. significa . Quindi si riduce a e, poiché è chiusa, .
- Conclusione. Dalle due inclusioni, .
La dispensa ottiene il passo 3 passando per la Proposizione B ( è -completo); il ragionamento è lo stesso, scritto qui in modo diretto. Applicazione: NP è chiusa, quindi se un problema NP-completo stesse in coNP si avrebbe .
Dove serve nelle tracce
F02 n. 5 · F03 n. 1 · F03 n. 4 · F03 n. 7 · F04 n. 1 · F04 n. 7 · F07 n. 4 · F08 n. 3 · F12 n. 2 · F12 n. 5 · F14 n. 2 · F14 n. 7 · G20v1 n. 4 · G20v3 n. 1 · MZ22 n. 1 · LU22 n. 7 · LU24 n. 5 · ND n. 6
Dove: dispensa cap. 14, p. 54; appunti Lez. 8
proposizioneSe allora
per l'oraledimostrato nel corsoSe , allora anche .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Se allora
Intuizione
P è chiusa per complemento: .
All'esame
Le risposte "solo se " portano con sé anche ; il viceversa non è noto.
Da scrivere all'esame
Se allora , perché P è chiusa per complemento: .
Dimostrazione
Idea: P è chiusa per complemento, quindi se anche il complemento di ogni problema di NP sta in NP.
- P è chiusa per complemento. Se , una macchina deterministica decide in tempo polinomiale e si ferma sempre con SÌ o NO. Scambiando le due risposte si ottiene una macchina, con lo stesso budget di tempo, che decide (il complemento di ). Quindi , cioè .
- . Supponiamo e sia . Allora , quindi per il passo 1 .
- . Sia . Per il passo 1 , quindi per definizione .
- Conclusione. ; in breve, .
Lo scambio di risposte non funziona per una macchina nondeterministica: lì SÌ vuol dire “almeno un ramo accetta”, e la sua negazione è “tutti i rami rifiutano”. Per questo il viceversa non è noto: potrebbe essere anche con .
Dove: dispensa cap. 14, p. 54; appunti Lez. 4
proposizioneProposizione
chiesto in 6 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione
Intuizione
Se anche il suo complemento è in , quindi ; e .
All'esame
Un problema in P ha sia certificati succinti sia squalifiche succinte; esistono problemi in non noti in P.
Da scrivere all'esame
: ogni problema in P sta in NP e, poiché P è chiusa per complemento, anche in coNP.
Dimostrazione
Idea: un problema di P sta in NP perché una macchina deterministica è un caso particolare di macchina nondeterministica; sta in coNP perché P è chiusa per complemento.
- Sia .
- . Una macchina deterministica è una macchina nondeterministica con una sola scelta a ogni passo, quindi .
- . P è chiusa per complemento: scambiando le risposte SÌ e NO della macchina deterministica, che si ferma sempre, si decide il complemento con lo stesso budget di tempo.
- . Dal passo 3, ; per definizione di coNP (i linguaggi il cui complemento sta in NP), .
- Conclusione. Dai passi 2 e 4, . Poiché era qualsiasi, .
Dove: dispensa cap. 14, p. 55; appunti Lez. 8
Capitolo 15 · Problemi di ottimizzazione (DP)
proposizioneEXACT TSP è NP-hard (varianti di TSP)
per l'oraledimostrato nel corsoLe quattro varianti TSP(D), EXACT TSP, TSP COST e TSP si riducono ciascuna alla successiva; in particolare EXACT TSP è NP-hard. Lo si mostra riducendo HAMILTON CYCLE a EXACT TSP (il grafo ha un ciclo hamiltoniano se e solo se il giro ottimo costa esattamente ).
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
EXACT TSP è NP-hard (varianti di TSP)
Intuizione
Chi sa trovare il giro ottimo sa anche dire quanto costa, e quindi se costa esattamente o al più .
All'esame
EXACT TSP non sembra stare né in NP né in coNP: è il problema che motiva la classe DP.
Da scrivere all'esame
EXACT TSP è NP-hard: con distanze 1 sugli archi e 2 altrove, ha un ciclo hamiltoniano se e solo se il giro ottimo costa esattamente .
Dimostrazione
Idea: ogni variante sa rispondere a quella prima (chi trova il giro ottimo ne conosce il costo, e chi conosce il costo sa dire se è esattamente ). Per la difficoltà di EXACT TSP si usa la riduzione con distanze 1 e 2, partendo da HAMILTON CYCLE con .
- Le varianti. TSP(D): esiste un giro di costo ? EXACT TSP: il giro ottimo costa esattamente ? TSP COST: quanto costa il giro ottimo? TSP: trovare un giro ottimo.
- EXACT TSP → TSP COST → TSP (banali). Se si sa trovare un giro ottimo (TSP), sommando le sue tratte si ottiene il costo ottimo (TSP COST). Se si conosce il costo ottimo (TSP COST), si risponde a EXACT TSP confrontando con .
- HAMILTON CYCLE si riduce a EXACT TSP. Dato con nodi, si costruiscono città con (distanza tra e ) se è un arco di e 2 altrimenti, e si pone . Ogni giro ha tratte di costo almeno 1, quindi il giro ottimo costa almeno , ed esattamente se e solo se esiste un giro fatto solo di archi di , cioè un ciclo hamiltoniano. Quindi ha un ciclo hamiltoniano il giro ottimo costa esattamente .
- Perché serve un ciclo e non un cammino. Partendo da HAMILTON PATH nessun valore di funziona: un triangolo ha un cammino hamiltoniano e il suo giro ottimo costa , mentre il grafo –– ha un cammino hamiltoniano ma il giro ottimo costa . Un cammino hamiltoniano non fissa il costo ottimo (può essere o ); un ciclo hamiltoniano sì.
- EXACT TSP è NP-hard. HAMILTON CYCLE è NP-completo (HAMILTON PATH vi si riduce aggiungendo un nodo collegato a tutti gli altri, come nella prova di TSP(D)). Ogni problema di NP, in particolare TSP(D), si riduce a HAMILTON CYCLE e quindi, componendo le riduzioni (una composizione di riduzioni è una riduzione), a EXACT TSP. Così si ottiene anche il primo anello TSP(D) → EXACT TSP.
Problemi
Dove: dispensa cap. 15, p. 58; slide Lez. 9
teoremaSAT-UNSAT è DP-completo
chiesto in 2 domandedimostrato nel corsoDate due formule e in CNF con 3 letterali per clausola, decidere se è soddisfacibile e no è DP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
SAT-UNSAT è DP-completo
Intuizione
Sta in DP perché è l'intersezione di un problema NP ( soddisfacibile) e di uno coNP ( insoddisfacibile); per la difficoltà, se si usa con le riduzioni a SAT.
All'esame
È il DP-completo di riferimento: per esempio SAT-UNSAT si riduce a perché .
Da scrivere all'esame
SAT-UNSAT è DP-completo e : quindi si riduce a ogni problema - o -completo con (per esempio ).
Dimostrazione
Idea: SAT-UNSAT chiede due cose insieme, una di tipo NP ( è soddisfacibile) e una di tipo coNP ( non lo è). Per la difficoltà, le due condizioni di un qualsiasi problema di DP si traducono ciascuna in una formula, con le riduzioni a SAT, e si mettono in coppia.
- Ricordiamo la definizione. se esistono e con ( = intersezione: deve stare in entrambi).
- SAT-UNSAT sta in DP. Prendiamo e . è 3-SAT sulla prima formula (la seconda si ignora), quindi sta in NP: il certificato è un assegnamento che soddisfa . è il complemento di 3-SAT sulla seconda formula, quindi sta in coNP. Le istanze "sì" di SAT-UNSAT sono esattamente quelle in .
- Difficoltà: cosa sappiamo di un qualsiasi in DP. Solo che con e . Allora il complemento sta in NP.
- Due riduzioni. 3-SAT è NP-completo, quindi esistono una riduzione da a 3-SAT e una riduzione da a 3-SAT. Dunque è soddisfacibile, e è soddisfacibile, cioè è insoddisfacibile.
- La riduzione. Poniamo . Si calcola eseguendo prima e poi , quindi resta una riduzione in spazio logaritmico.
- Correttezza. è soddisfacibile e no e .
Ogni problema di DP si riduce a SAT-UNSAT, che sta in DP: SAT-UNSAT è DP-completo.
Classi
Problemi
Dove: dispensa cap. 15, p. 59; slide Lez. 9
proposizioneAltri problemi DP-completi
chiesto in 3 domandeSono DP-completi anche EXACT TSP (la difficoltà si ottiene riducendo SAT-UNSAT), CRITICAL SAT, CRITICAL HAMILTON PATH e CRITICAL 3-COLORING. UNIQUE SAT sta in DP, ma non si sa se sia DP-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Altri problemi DP-completi
Intuizione
Sono tutte domande "esatte" o "critiche" che combinano una parte sì (NP) e una parte no (coNP) sulla stessa istanza.
Da scrivere all'esame
Le versioni esatte e critiche (EXACT TSP, CRITICAL SAT, …) sono DP-complete: intersezione di un problema NP e di uno coNP, e SAT-UNSAT si riduce a esse.
Schema della dimostrazione
Idea: per l'appartenenza a DP si scrive ogni problema come "una parte sì" (in NP) e "una parte no" (in coNP) sulla stessa istanza; la difficoltà si ottiene riducendo SAT-UNSAT. Il corso dà solo gli enunciati; qui c'è lo schema della prova standard (Papadimitriou, cap. 17).
- . "Il tour ottimo costa esattamente " equivale a: costo ottimo (è TSP(D), in NP: il certificato è un tour di costo ) e costo ottimo (in coNP: il complemento "esiste un tour di costo " sta in NP).
- . " è insoddisfacibile" sta in coNP. "Togliendo una qualsiasi clausola diventa soddisfacibile" sta in NP: il certificato è una lista di assegnamenti, uno per ogni clausola tolta; sono tante quante le clausole, quindi la lista è lunga un polinomio e si verifica in tempo polinomiale.
- e . Stesso schema: "il grafo non ha un cammino hamiltoniano" (o "non è 3-colorabile") sta in coNP; "dopo ogni modifica permessa la proprietà vale" sta in NP, perché le modifiche possibili sono al più ( = numero di nodi) e per ciascuna basta un certificato (un cammino, una colorazione).
- . " ha almeno un assegnamento che la soddisfa" sta in NP; "ne ha al più uno" sta in coNP, perché il complemento "ne ha almeno due" sta in NP (certificato: due assegnamenti diversi). Non si conosce una riduzione da SAT-UNSAT, quindi non si sa se sia DP-completo.
- Difficoltà di EXACT TSP (schema). Data , si usa la riduzione da 3-SAT a HAMILTON PATH, modificata in modo che il grafo ottenuto abbia sempre un cammino che "salta" un solo arco: nell'istanza TSP (distanze 1 sugli archi, 2 altrove) il costo ottimo è se è soddisfacibile e se no. Si fa lo stesso per raddoppiando le distanze: costo oppure . Unendo le due istanze in una, il costo ottimo è la somma (più una costante fissa per il collegamento), e i quattro casi danno quattro valori diversi: , , , . Si sceglie uguale al valore del caso " soddisfacibile, no" ().
- Difficoltà degli altri. Si ottiene con riduzioni da SAT-UNSAT più tecniche, dello stesso tipo: si costruisce un'istanza la cui parte "sì" codifica e la parte "no" codifica .
Dove serve nelle tracce
Classi
Problemi
SAT · HAMILTON PATH · 3-COL · SAT-UNSAT · EXACT TSP
Dove: dispensa cap. 15, p. 60; slide Lez. 9
Capitolo 16 · Macchine con oracolo
proposizioneProposizione (oracoli NP-completi equivalenti)
per l'oraledimostrato nel corsoPer ogni linguaggio NP-completo, .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (oracoli NP-completi equivalenti)
Intuizione
Ogni domanda all'oracolo si traduce con una riduzione in una domanda a SAT, e viceversa, con costo polinomiale.
All'esame
Per questo si scrive , , invece di , , .
Da scrivere all'esame
Per ogni NP-completo : le domande all'oracolo si traducono con una riduzione polinomiale, quindi conta solo la classe dell'oracolo.
Dimostrazione
Idea: due problemi NP-completi si riducono l'uno all'altro; quindi ogni domanda fatta all'oracolo si può tradurre in una domanda a SAT (e viceversa) spendendo solo tempo polinomiale.
- Le riduzioni esistono. è in NP e SAT è NP-completo, quindi esiste una riduzione da a SAT: . Viceversa SAT è in NP e è NP-completo, quindi esiste una riduzione da SAT a . Entrambe si calcolano in tempo polinomiale; chiamiamo il budget di tempo di .
- . Sia una macchina deterministica con oracolo che lavora con budget di tempo (un polinomio). Costruiamo con oracolo SAT: fa esattamente come , ma quando sta per interrogare l'oracolo su una stringa , calcola , la scrive sul nastro di query e interroga SAT. La risposta è la stessa, perché , quindi accetta esattamente gli stessi input di .
- Il costo resta polinomiale. In passi fa al più domande, e ogni domanda è lunga al più (non si possono scrivere più simboli dei passi fatti). Tradurre una domanda costa al più passi. In totale impiega al più passi: un polinomio, perché composizioni e prodotti di polinomi sono polinomi.
- . Stesso argomento con la riduzione al posto di .
Quindi : conta solo la classe dell'oracolo e si scrive . Lo stesso ragionamento vale per , e ogni classe il cui budget assorbe il costo delle riduzioni.
Classi
Problemi
Dove: dispensa cap. 16, p. 63; slide Lez. 9
proposizioneProposizione
per l'oraledimostrato nel corsoPer ogni classe e ogni classe di oracoli : .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione
Intuizione
Basta scambiare gli stati e : l'oracolo è una scatola nera che risponde in un passo.
All'esame
Per questo non si scrivono o : per esempio .
Da scrivere all'esame
(basta scambiare e ): per esempio .
Dimostrazione
Idea: l'oracolo è una scatola nera che risponde "sì" o "no" in un passo. Chiedere "?" oppure "?" ( = complemento di ) dà la stessa informazione: basta leggere la risposta al contrario, cioè scambiare gli stati e .
- Punto di partenza. Sia : esistono un linguaggio e una macchina , del tipo e con il budget (di tempo o di spazio) della classe , che decide .
- La nuova macchina. Costruiamo uguale a , ma con e scambiati nella tabella di transizione: ciò che fa dopo aver ricevuto , lo fa dopo aver ricevuto , e viceversa. Diamo a l'oracolo , che sta in .
- Le due computazioni coincidono. Per ogni domanda vale . Quindi quando riceve , riceve e, per lo scambio, fa la stessa mossa; lo stesso per l'altra risposta. Passo dopo passo le due macchine fanno le stesse cose.
- Stesse risorse. ha lo stesso tipo di (deterministica o no) e usa gli stessi passi e lo stesso spazio, quindi rispetta il budget di . Dunque , e .
- Verso opposto. Si ripete lo stesso argomento partendo da : il complemento di un linguaggio di sta in . Quindi .
Per questo non si scrivono o : sono e .
Dove: dispensa cap. 16, p. 63; slide Lez. 9
proposizioneOracoli inutili e
★ chiesto in 10 domandedimostrato nel corso e ; inoltre . Non si sa se .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Oracoli inutili e
Intuizione
Un oracolo in P si esegue "in linea" con costo polinomiale; una domanda NP e una coNP si risolvono con due chiamate a un oracolo NP.
All'esame
Colloca DP dentro , per esempio per le riduzioni da SAT-UNSAT verso i livelli più alti di PH.
Da scrivere all'esame
e (oracolo eseguito in linea); , perché bastano due domande a un oracolo NP.
Dimostrazione
Idea: un oracolo in P non serve, perché la sua risposta si può calcolare "in linea" con un costo polinomiale. Un problema di DP si risolve con due domande a un oracolo NP, quindi .
- e . Una macchina con oracolo può semplicemente non usarlo.
- . Sia deterministica con budget di tempo e oracolo , deciso da una macchina con budget . Costruiamo senza oracolo: fa come , ma al posto di ogni domanda esegue su come sottoprogramma e prosegue con la risposta ottenuta. Le domande sono al più , ognuna lunga al più , e ognuna costa al più : in totale passi, un polinomio.
- . Stessa costruzione con non deterministica: il sottoprogramma è deterministico e dà la risposta giusta su ogni ramo, e ogni ramo resta polinomiale.
- Perché non funziona con . Se l'oracolo è in NP, eseguirlo in linea vuol dire indovinare un certificato. Questo basta per le risposte "sì", ma una risposta "no" richiede di escludere tutti i certificati, e una macchina non deterministica non sa farlo in tempo polinomiale (a meno che ). Per questo non si sa se .
- . Sia con , . Come per SAT-UNSAT esistono riduzioni da a SAT e dal complemento di a SAT. La macchina deterministica con oracolo SAT: calcola e chiede; se la risposta è "no" rifiuta; altrimenti calcola e chiede; accetta se e solo se la risposta è "no". Sono due domande e tempo polinomiale, e accetta e .
- Dove sta . Per definizione . Una macchina deterministica è un caso particolare di macchina non deterministica, quindi . Inoltre è chiusa per complemento (si scambiano accettazione e rifiuto della macchina deterministica), quindi .
Conclusione da ricordare: , e quindi per ogni .
Dove serve nelle tracce
F07 n. 2 · G16 n. 3 · G20v1 n. 3 · G20v2 n. 2 · G20v3 n. 1 · G20v5 n. 1 · G20v5 n. 3 · MZ22 n. 2 · GE23 n. 7 · MA23 n. 6
Dove: dispensa cap. 16, p. 63; slide Lez. 9
Capitolo 17 · Gerarchia polinomiale
teoremaTeorema 17.8 (certificati per )
per l'oraledimostrato nel corsoPer ogni , se e solo se esiste una relazione polinomialmente bilanciata, con in , tale che .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 17.8 (certificati per )
Intuizione
Ogni livello aggiunge un "esiste" davanti a un controllo del livello di sotto; per è la Proposizione 9.1 su NP.
All'esame
È la base della prova del collasso (Teorema 17.9) e dell'appartenenza di a .
Da scrivere all'esame
Per il Teorema 17.8, sse con polinomialmente bilanciata e verificabile in .
Dimostrazione
Idea: per induzione su . Il certificato di è la descrizione di una computazione accettante della macchina con oracolo: le sue scelte non deterministiche e, per ogni domanda all'oracolo con risposta "sì", un certificato di quella risposta. Notazione: (macchine non deterministiche polinomiali con oracolo nel livello sotto), ; è polinomialmente bilanciata se implica per un fisso; "" è la coppia scritta come un'unica stringa.
- Caso base . e : l'enunciato dice che se e solo se ha certificati corti verificabili in tempo polinomiale. È la Proposizione 9.1.
- Passo, verso "se". Supponiamo che esista e sia ; allora il complemento sta in . La macchina per : (a) indovina con , in tempo polinomiale perché è bilanciata; (b) chiede all'oracolo se ; (c) accetta se la risposta è "no", cioè se . Esiste un ramo che accetta esiste con . È una macchina non deterministica polinomiale con oracolo in , quindi .
- Passo, verso "solo se": i dati. Sia , decisa da non deterministica con budget di tempo e oracolo . Per ipotesi di induzione , con polinomialmente bilanciata e .
- Il certificato. contiene le scelte non deterministiche di su e, per ogni domanda con risposta "sì", un con . Le scelte sono al più , le domande al più e lunghe al più , i lunghi al più : è polinomiale. Poniamo descrive una computazione accettante di su con risposte dell'oracolo corrette. Allora esiste con .
- Resta: . Si simula seguendo le scelte scritte in e si controllano le risposte. Per le risposte "sì": verificare è un problema di , cioè una domanda (con risposta letta al contrario) a un oracolo di ; questa parte è un calcolo deterministico polinomiale con oracolo in , che sta in . Per le risposte "no": serve , e il complemento di sta in .
- Mettere insieme i controlli. Sono un numero polinomiale di condizioni, tutte in . Una macchina di tipo accetta quando tutti i suoi rami accettano, quindi può eseguire i controlli uno dopo l'altro: accetta su tutti i rami ogni controllo è superato. Quindi la congiunzione sta in .
Così ha tutte le proprietà richieste e l'induzione è completa.
Dove: dispensa cap. 17, p. 64; slide Lez. 9. La dispensa omette la prova; le slide della Lez. 9 la danno per induzione su .
corollarioCorollario 1 del Teorema 17.8 (certificati per )
per l'oraledimostrato nel corsoPer ogni , se e solo se esiste una relazione polinomialmente bilanciata, con in , tale che .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario 1 del Teorema 17.8 (certificati per )
Intuizione
: complementando, "esiste" diventa "per ogni".
Da scrivere all'esame
Per il Corollario 1 del Teorema 17.8, sse con polinomialmente bilanciata e verificabile in .
Dimostrazione
Idea: (il livello Pi i della gerarchia) è esattamente , l'insieme dei complementi dei linguaggi di . Complementando la caratterizzazione del Teorema 17.8, "esiste " diventa "per ogni " e la verifica passa da a .
- Solo se. Sia . Allora il complemento sta in , e per il Teorema 17.8 esiste polinomialmente bilanciata () con e .
- Negazione. nessun va bene per ogni con vale . Il limite non toglie nulla, perché contiene solo coppie con corto.
- La nuova relazione. Poniamo . È polinomialmente bilanciata per costruzione, e .
- Classe della verifica. Verificare significa controllare la lunghezza (tempo polinomiale) e rispondere "no" al problema , che sta in . Il complemento di un problema di sta in , e aggiungere un controllo polinomiale non cambia la classe. Quindi .
- Se. Al contrario, se ha questa forma, il suo complemento è : la relazione " corto e " è bilanciata e verificabile in , quindi per il Teorema 17.8 e .
Qui il limite va scritto esplicitamente: con "per ogni" non lo garantisce più la relazione.
Dove: dispensa cap. 17, p. 64; slide Lez. 9
corollarioCorollario 2 del Teorema 17.8 (forma con i quantificatori)
chiesto in 1 domandadimostrato nel corsoPer ogni , se e solo se esiste una relazione polinomialmente bilanciata e decidibile in tempo polinomiale tale che , dove è se è dispari e se è pari.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario 2 del Teorema 17.8 (forma con i quantificatori)
Intuizione
Il livello di un problema nella gerarchia è il numero di alternanze di quantificatori davanti a un controllo polinomiale.
All'esame
Si usa per collocare un problema in contando i quantificatori, e per mostrare che .
Da scrivere all'esame
Per il Corollario 2 del Teorema 17.8, sse con polinomiale: il livello è il numero di alternanze.
Dimostrazione
Idea: si applicano a ripetizione il Teorema 17.8 e il Corollario 1: ogni volta un livello diventa " + verifica nel livello di sotto" e un livello diventa " + verifica nel livello di sotto", fino ad arrivare al livello 0, che è P.
- Cosa si dimostra. Per induzione su dimostriamo insieme due cose: () sse ; () sse vale la stessa forma con i quantificatori scambiati (). In entrambe è polinomialmente bilanciata (ogni ) e decidibile in tempo polinomiale. La () segue dalla () complementando: ha la forma () con la relazione , e negare scambia e e sostituisce con il suo complemento, ancora polinomiale.
- Caso base . con polinomiale: è la caratterizzazione di (Proposizione 9.1).
- Passo (solo se). Sia . Per il Teorema 17.8, con . Per l'ipotesi di induzione (forma ) questo linguaggio è con polinomiale. Basta porre .
- Le lunghezze restano polinomiali. e ogni successivo è polinomiale in , quindi in : un polinomio di un polinomio è un polinomio.
- Passo (se). Se ha la forma , il linguaggio ha la forma () con quantificatori, quindi sta in per l'ipotesi di induzione. Per il Teorema 17.8 (verso "se"), .
L'ultimo quantificatore è se è dispari e se è pari, perché i quantificatori si alternano partendo da .
Dove serve nelle tracce
Dove: dispensa cap. 17, p. 65; slide Lez. 9
teoremaTeorema 17.9 (collasso di PH)
★ chiesto in 23 domandedimostrato nel corsoSe per qualche vale , allora per ogni : , cioè la gerarchia polinomiale collassa al livello .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 17.9 (collasso di PH)
Intuizione
Basta mostrare : due "esiste" consecutivi si fondono in uno solo, poi si ripete salendo.
All'esame
È lo strumento delle risposte "solo se PH collassa": per esempio una riduzione da al suo complemento esiste solo se PH collassa al livello .
Da scrivere all'esame
Per il Teorema 17.9, se allora PH collassa al livello : per esempio una riduzione da al suo complemento esiste solo se PH collassa al livello .
Dimostrazione
Idea: un problema di è "esiste " davanti a una verifica in . Se , quella verifica comincia a sua volta con un "esiste "; i due "esiste" consecutivi si fondono in uno solo (si indovina la coppia ) e si torna a . Poi si ripete salendo.
- Basta un livello. Vale sempre . Mostriamo che, se , vale anche . Da qui: ; e sta tra e , quindi è anch'esso uguale a . In particolare : l'ipotesi vale al livello , e ripetendo l'argomento (induzione su ) si ottiene per ogni .
- Primo "esiste". Sia . Per il Teorema 17.8 esiste polinomialmente bilanciata con e il linguaggio in .
- Uso dell'ipotesi. Poiché , il linguaggio sta in . Applichiamo di nuovo il Teorema 17.8, con input la stringa : esiste polinomialmente bilanciata, con verifica in , tale che esiste con .
- Fusione dei due "esiste". Quindi esistono e con . Definiamo : contiene le stesse stringhe, solo raggruppate diversamente, quindi la sua verifica è lo stesso problema e sta ancora in . E esiste una stringa con .
- è polinomialmente bilanciata. e , quindi : un polinomio in .
- Conclusione del passo. Per il Teorema 17.8 (verso "se") applicato a , . Quindi .
Per la verifica di sta in e tutto funziona allo stesso modo. Risultato: , cioè la gerarchia "collassa al livello ".
Dove serve nelle tracce
F03 n. 1 · F03 n. 7 · F04 n. 1 · F04 n. 7 · F06 n. 2 · F07 n. 4 · F07 n. 7 · F08 n. 3 · F12 n. 2 · F12 n. 5 · F13 n. 1 · L18 n. 1 · L18 n. 7 · G20v1 n. 1 · G20v1 n. 4 · G20v3 n. 1 · G20v5 n. 1 · MZ22 n. 2 · LU22 n. 7 · FE23 n. 7 · MA23 n. 2 · E26 n. 5 · ND n. 6
Dove: dispensa cap. 17, p. 65; slide Lez. 9
corollarioCorollario (collasso al primo livello)
★ chiesto in 10 domandedimostrato nel corsoSe , o anche solo , la gerarchia polinomiale collassa al primo livello.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario (collasso al primo livello)
Intuizione
È il Teorema 17.9 con .
All'esame
Senza una prova di non si può dimostrare che PH sia davvero una gerarchia; serve per le risposte "solo se ".
Da scrivere all'esame
Se (in particolare se ) allora, per il Teorema 17.9 con , PH collassa al primo livello: .
Dimostrazione
Idea: è il Teorema 17.9 con , perché e .
- Caso . Al primo livello della gerarchia e . L'ipotesi dice quindi , che è l'ipotesi del Teorema 17.9 con . Il teorema dà, per ogni , : tutta la gerarchia è uguale a NP.
- Caso . P è chiusa per complemento (una macchina deterministica si complementa scambiando accettazione e rifiuto), quindi . Allora , cioè vale e si applica il caso precedente. Anzi, qui la gerarchia è tutta uguale a P.
Conseguenza: finché non si dimostra (anzi ), non si può dimostrare che i livelli di PH siano davvero distinti.
Dove serve nelle tracce
F03 n. 1 · F03 n. 7 · F04 n. 1 · F04 n. 7 · F12 n. 2 · F12 n. 5 · F14 n. 2 · G20v1 n. 4 · LU22 n. 7 · ND n. 6
Dove: dispensa cap. 17, p. 66; slide Lez. 9
teoremaTeorema (CIRC SAT e CIRC VALIDITY)
chiesto in 3 domandedimostrato nel corsoNella logica della Circumscription, decidere se un modello di KB soddisfa (CIRC SAT) è -completo; decidere se (CIRC VALIDITY) è -completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema (CIRC SAT e CIRC VALIDITY)
Intuizione
È SAT più una minimizzazione degli "anormali": esiste un modello tale che nessun altro modello è più normale, cioè , secondo livello.
All'esame
Esempio di problema completo al 2° livello: CLIQUE si riduce a CIRC SAT, mentre il contrario farebbe collassare PH al primo livello.
Da scrivere all'esame
CIRC SAT è -completo ( un modello, modello più normale): CLIQUE vi si riduce perché ; il contrario farebbe collassare PH al primo livello.
Dimostrazione
Idea: CIRC SAT chiede se esiste un assegnamento che soddisfa e e tale che nessun altro assegnamento sia più normale: un seguito da un , quindi . Per la difficoltà si riduce costruendo una i cui modelli minimi "scelgono" le e sono costretti a soddisfare per ogni scelta delle . (Circumscription, non CIRCUIT SAT.)
Notazione: è l'insieme delle proposizioni "anormali"; ( strettamente più normale) se ogni falsa in è falsa anche in e almeno una vera in è falsa in . Un modello di è un con ( soddisfa ) e nessun con .
- Appartenenza. Il problema " non è un modello -minimo di " sta in NP: si indovina e si verifica in tempo polinomiale che e . L'algoritmo per CIRC SAT indovina , verifica in tempo polinomiale e , chiede all'oracolo se non è minimo e accetta se la risposta è "no". È in .
- Riduzione. Data , poniamo con nuove, = tutte le proposizioni, domanda .
- Due proprietà di ogni modello . (a) Esattamente una tra e è vera: almeno una per la clausola; se fossero vere entrambe, rendendo falsa (che compare solo nella sua clausola) resterebbe soddisfatta con un più normale. (b) Se , allora tutte le sono vere, per le formule .
- vera vera in un modello. Sia un assegnamento delle tale che ogni estensione alle soddisfi . : le come , , tutte le vere. (estende ) e . Minimo: se e è almeno tanto normale, su ogni coppia non può spegnere l'unica vera (violerebbe la clausola), quindi coincide con sulle ; allora qualunque siano le sue , e per (b) ha tutte le vere: .
- vera in un modello vera. Sia la parte di sulle . Per assurdo un'estensione falsifica . : e come in , come , . : le clausole valgono e le implicazioni sono vere perché è falsa. Ma per (b) ha tutte le vere, mentre ne ha una sola per coppia: , contro la minimalità di .
- CIRC VALIDITY. nessun modello soddisfa . È il complemento di CIRC SAT, quindi -completo ().
Dove serve nelle tracce
Dove: dispensa cap. 17, pp. 69–70; slide Lez. 9. La dispensa omette la prova (riduzione da ); le slide della Lez. 9 la svolgono per CIRC SAT.
teoremaTeorema 17.10 ( è -completo)
★ chiesto in 30 domandedimostrato nel corsoDecidere se è vera una QBF con i blocchi alternati di quantificatori () è -completo; il suo complemento è -completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 17.10 ( è -completo)
Intuizione
Il numero di alternanze di quantificatori coincide con il livello della gerarchia; la difficoltà si mostra come nel Teorema di Cook.
All'esame
Dà un problema completo per ogni livello: sì; solo se PH collassa al 2° livello.
Da scrivere all'esame
Per il Teorema 17.10 è -completo e il complemento -completo: si riduce a (); il contrario solo se PH collassa al 2° livello.
Dimostrazione
Idea: l'appartenenza viene dal Corollario 2 del Teorema 17.8, perché ha già la forma con una verifica polinomiale. Per la difficoltà si fa come nel Teorema di Cook: la verifica polinomiale diventa una formula; le variabili che descrivono si quantificano come nel Corollario 2, e le altre variabili della tabella di Cook si aggiungono con un che si fonde con l'ultimo blocco.
- Appartenenza. Data , sia un assegnamento di verità al blocco , e soddisfano . è polinomialmente bilanciata (un assegnamento è lungo al più ) e si decide in tempo polinomiale valutando . è vera , quindi per il Corollario 2 , e il complemento sta in .
- Complemento. . Quindi è "decidere se è vera una QBF con blocchi alternati che comincia con ". Una riduzione da a è anche una riduzione da a , e : basta dimostrare la completezza di uno dei due, l'altra segue.
- Difficoltà, dispari. Sia . Per il Corollario 2, , con e decisa da una macchina deterministica con budget di tempo polinomiale.
- La formula di Cook. Come nel Teorema di Cook, la computazione di sull'input si descrive con una formula , costruita in spazio logaritmico. Le variabili della prima riga del nastro sono: quelle di , fissate a costanti; un gruppo che rappresenta ; …; un gruppo che rappresenta . è l'insieme di tutte le altre (righe successive, stati, posizioni della testina). Per Cook, fissati i valori di , esiste un valore di che soddisfa accetta .
- La QBF. Quindi . Poiché è dispari l'ultimo blocco è , e è un unico blocco: la formula ha esattamente blocchi alternati, cioè è un'istanza di . è -difficile, e per il punto 2 è -difficile.
- Difficoltà, pari. Partendo da l'ultimo blocco sarebbe seguito da : un'alternanza in più. Si parte allora da : per il Corollario 1 applicato a ripetizione, con polinomiale. Con la stessa costruzione ; ora l'ultimo blocco è e si fonde con : blocchi che cominciano con , un'istanza di . Quindi è -difficile e, per il punto 2, è -difficile.
Con l'appartenenza: è -completo e il suo complemento è -completo, per ogni .
Dove serve nelle tracce
F02 n. 7 · F03 n. 1 · F03 n. 5 · F04 n. 1 · F05 n. 6 · F06 n. 2 · F07 n. 2 · F08 n. 3 · F08 n. 5 · G16 n. 4 · G16 n. 6 · F12 n. 2 · F12 n. 5 · F13 n. 1 · F13 n. 3 · F14 n. 6 · L18 n. 5 · G20v1 n. 1 · G20v2 n. 7 · G20v4 n. 1 · G20v5 n. 2 · LU22 n. 1 · GE23 n. 1 · GE23 n. 5 · FE23 n. 3 · FE23 n. 7 · SE23 n. 1 · SE23 n. 6 · E26 n. 5 · ND n. 7
Dove: dispensa cap. 17, p. 70; slide Lez. 9. La dispensa lo chiama solo "Theorem" e omette la prova; il numero 17.10 e la prova vengono dalle slide della Lez. 9. Il riepilogo del cap. 22 elenca anche il complemento di come -completo (la barra del complemento si perde nell'estrazione del testo).
teoremaSTRATEGIC COMPANIES è -completo
chiesto in 1 domandadimostrato nel corsoUna società è strategica se appartiene ad almeno un gruppo che produce tutte le merci, include le società controllate dalle società scelte e non può essere ridotto mantenendo queste condizioni. Decidere se una società è strategica è -completo; il suo complemento è -completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
STRATEGIC COMPANIES è -completo
Intuizione
"Esiste un insieme che contiene la società e tale che nessun suo sottoinsieme proprio va bene": un seguito da un , come .
All'esame
Altro problema completo al 2° livello negli esercizi di riduzione (per esempio CLIQUE si riduce al complemento di STRATEGIC COMPANIES perché ).
Da scrivere all'esame
STRATEGIC COMPANIES è -completo e il complemento -completo: CLIQUE si riduce al complemento perché ; il contrario farebbe collassare PH al primo livello.
Dimostrazione
Idea: è strategica se esiste un insieme che la contiene, va bene, e nessun suo sottoinsieme proprio va bene: seguito da , quindi . La difficoltà si mostra riducendo : le società-letterale delle codificano un assegnamento, e una società speciale obbliga a tenere tutte le società-letterale delle .
Notazione: va bene se (1) le società di producono tutte le merci , e (2) chiusura: se un insieme di controllo è tutto in , allora . è strategica se sta in un che va bene ed è minimo (nessun va bene).
- Appartenenza. " non è minimo" sta in NP: si indovina e si verificano (1) e (2) in tempo polinomiale. L'algoritmo indovina con , verifica (1) e (2), chiede all'oracolo se non è minimo e accetta se la risposta è "no": .
- Riduzione. Sia con disgiunzione di termini (resta -difficile: è la negazione della forma CNF data dalla prova del Teorema 17.10). Società: . Merci , ciascuna prodotta solo dai due letterali della sua variabile. Controlli: e controllate solo da sé stesse (nessun vincolo); controllate da (se tutte le -letterali sono in ); controllata da ogni termine di . Si chiede se è strategica.
- vera strategica. Sia sulle tale che ogni estensione soddisfi . = letterali delle veri in , tutte le , e . va bene. Minimo: sia che va bene. Deve avere gli stessi letterali delle (sono gli unici produttori delle ), quindi perde qualche -letterale o ; se la chiusura rimette tutte le -letterali, quindi . Per ogni contiene o : sia con vera . soddisfa , quindi un termine è vero e i suoi tre letterali veri stanno tutti in : la chiusura impone . Assurdo.
- strategica vera. Sia minimo con ; per la chiusura contiene tutte le -letterali, e per la minimalità un solo letterale per ogni (l'altro si potrebbe togliere). : vera . Per assurdo un'estensione rende falsa. = letterali delle di più i letterali delle veri in , senza . produce tutte le merci; la chiusura per le vale perché ; quella per vale perché ogni termine ha un letterale falso, che non sta in . Quindi va bene: contro la minimalità di .
- Complemento. Poiché , il complemento di STRATEGIC COMPANIES è -completo.
Dove serve nelle tracce
Problemi
Dove: dispensa cap. 17, p. 70; dispensa cap. 22, p. 85; slide Lez. 9. La dispensa omette la prova (riduzione da ); le slide della Lez. 9 la svolgono. Nell'esercizio 3 del cap. 17 e nel riepilogo del cap. 22 la versione -completa è il complemento (barra persa nell'estrazione del testo).
teoremaTeorema 17.11 (niente problemi PH-completi)
chiesto in 4 domandedimostrato nel corsoSe esistesse un problema PH-completo, la gerarchia polinomiale collasserebbe a un livello finito.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 17.11 (niente problemi PH-completi)
Intuizione
Un problema PH-completo starebbe in qualche ; tutto si ridurrebbe a lui e, poiché ogni livello è chiuso rispetto alle riduzioni, .
All'esame
Serve per le risposte "solo se PH collassa" sui problemi completi per tutta PH.
Da scrivere all'esame
Per il Teorema 17.11 un problema PH-completo farebbe collassare PH a un livello finito: quindi un problema completo per PH (o per PSPACE in PH) esiste solo se PH collassa.
Dimostrazione
Idea: un problema PH-completo starebbe in un livello finito (perché PH è l'unione dei livelli). Tutti i problemi del livello sopra si ridurrebbero a , e i livelli sono chiusi rispetto alle riduzioni: il livello schiaccerebbe sul livello .
- sta in un livello. (unione di tutti i livelli). Se è PH-completo, , quindi esiste con .
- Tutto il livello sopra si riduce a . Sia . Poiché e è PH-difficile, esiste una riduzione da a : .
- I livelli sono chiusi rispetto alle riduzioni. Per decidere si calcola (tempo polinomiale) e poi si esegue la macchina che decide nel budget di su , che è lunga un polinomio in . Il totale resta nel budget di , quindi .
- Il livello è uguale al livello . Dal punto 3, , e l'inclusione opposta vale sempre: .
- Collasso. (ogni livello contiene quelli sotto), quindi . Complementando, . Dunque e per il Teorema 17.9 : la gerarchia collassa a un livello finito.
Dove: dispensa cap. 17, p. 70; slide Lez. 9
proposizioneProposizione 17.1 ()
★ chiesto in 18 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione 17.1 ()
Intuizione
Per ogni livello si provano tutti i certificati uno alla volta riusando lo spazio: sono di lunghezza polinomiale.
All'esame
Ogni problema di PH si riduce a QSAT; non si sa se .
Da scrivere all'esame
(Proposizione 17.1): quindi ogni problema di PH, per esempio , si riduce a QSAT, che è PSPACE-completo.
Dimostrazione
Idea: un problema di è " con una verifica polinomiale", e i certificati sono corti. Una macchina deterministica può provare tutti i certificati uno alla volta, riusando lo stesso spazio: ci mette moltissimo tempo, ma poco spazio.
- Forma del problema. Sia . Allora per qualche (per , e non c'è nulla da fare). Per il Corollario 2 del Teorema 17.8, con decidibile in tempo polinomiale e ogni .
- Valutazione ricorsiva. Per decidere "" si provano tutti gli di lunghezza , in ordine, come si incrementa un contatore; per ognuno si valuta ricorsivamente il resto ""; si risponde sì appena un funziona. Per "" si risponde sì solo se tutti funzionano. All'ultimo livello si verifica .
- Spazio per i certificati. In ogni momento bastano: il valore corrente di ciascun (al più simboli) e, per ogni livello , un'informazione su cosa si sta facendo (cercarne uno giusto o provarli tutti). è una costante fissata da , quindi in tutto : un polinomio. Passando al certificato successivo si riusa lo stesso spazio.
- Spazio per la verifica. La verifica di gira con un budget di tempo polinomiale, e una macchina non può usare più celle dei passi che fa: anche lo spazio è polinomiale, e si riusa a ogni verifica.
Il tempo è esponenziale (si provano tutti i certificati), ma lo spazio è polinomiale: . Quindi ; non si sa se l'inclusione sia stretta.
Dove serve nelle tracce
F04 n. 6 · F05 n. 1 · F06 n. 1 · F07 n. 1 · F08 n. 4 · F14 n. 3 · G17 n. 5 · L18 n. 1 · G20v2 n. 2 · G20v4 n. 2 · G20v5 n. 1 · MZ22 n. 2 · LU22 n. 5 · FE23 n. 3 · MA23 n. 6 · SE23 n. 4 · E26 n. 4 · E26 n. 7
Dove: dispensa cap. 17, p. 71; slide Lez. 9. La dispensa la enuncia senza prova; le slide della Lez. 9 danno la prova (cenni).
corollarioCorollario di 17.11 ( collasso)
chiesto in 4 domandedimostrato nel corsoSe , allora la gerarchia polinomiale collassa a un livello finito.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Corollario di 17.11 ( collasso)
Intuizione
PSPACE ha problemi completi (QSAT): se PH fosse uguale a PSPACE ne avrebbe anche lei, e per il Teorema 17.11 collasserebbe.
All'esame
Per questo si pensa che ; per esempio QSAT si riduce a solo se PH collassa.
Da scrivere all'esame
Se , QSAT sarebbe PH-completo e PH collasserebbe (Teorema 17.11): quindi QSAT si riduce a solo se PH collassa al 3° livello.
Dimostrazione
Idea: PSPACE ha un problema completo (QSAT). Se PH fosse uguale a PSPACE, QSAT sarebbe completo anche per PH, e il Teorema 17.11 dice che allora PH collassa.
- . Se , poiché si ha .
- QSAT è PH-difficile. Ogni sta in PSPACE (perché ) e QSAT è PSPACE-completo, quindi si riduce a QSAT.
- QSAT è PH-completo. Dai punti 1 e 2.
- Collasso. Per il Teorema 17.11, se esiste un problema PH-completo la gerarchia collassa a un livello finito . In più, in questo caso si avrebbe .
Poiché si crede che i livelli di PH siano tutti distinti, si crede anche che .
Dove serve nelle tracce
F04 n. 1 · F08 n. 3 · L18 n. 1 · G20v4 n. 4
Dove: dispensa cap. 17, p. 71; slide Lez. 9
teoremaQSAT è PSPACE-completo
★ chiesto in 8 domandedimostrato nel corsoDecidere se una QBF qualsiasi (senza limite alle alternanze di quantificatori) è vera è PSPACE-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
QSAT è PSPACE-completo
Intuizione
Sta in PSPACE con una valutazione ricorsiva che riusa lo spazio; per la difficoltà si codifica la raggiungibilità sul grafo delle configurazioni con QBF piccole, come il predicato PATH di Savitch.
All'esame
È il PSPACE-completo di riferimento: per esempio si riduce a QSAT perché .
Da scrivere all'esame
QSAT è PSPACE-completo: si riduce a QSAT perché , mentre il contrario implicherebbe e il collasso di PH.
Dimostrazione
Idea: QSAT sta in PSPACE perché si valuta la QBF ricorsivamente, provando prima e poi nello stesso spazio. Per la difficoltà, "la macchina in spazio polinomiale accetta" diventa una domanda di raggiungibilità sul grafo delle configurazioni, che si scrive con una QBF piccola usando il trucco del punto di mezzo di Savitch, più un che permette di scrivere una sola copia della formula.
- Appartenenza. Algoritmo Truth su : se valuta ; altrimenti calcola del resto con , poi con , riusando lo spazio; restituisce se , se . La ricorsione è profonda e ogni livello ricorda due bit e i valori assegnati: spazio più la valutazione di , polinomiale.
- Difficoltà: impostazione. Sia , deciso da con budget di spazio ; supponiamo che , prima di accettare, cancelli i nastri, così c'è una sola configurazione accettante. Una configurazione si descrive con bit, quindi ce ne sono al più , e nel grafo delle configurazioni c'è un cammino di lunghezza dalla configurazione iniziale a quella accettante.
- . Per blocchi di variabili, è vera e codificano configurazioni uguali o tali che segue in un passo. Si scrive come nel Teorema di Cook con una tabella di sole due righe: dimensione polinomiale in .
- Tentativo ingenuo. è corretta (un cammino lungo ha un punto di mezzo ), ma compare due volte: la dimensione raddoppia a ogni passo e sarebbe esponenziale.
- Il trucco. . Il percorre tutte le coppie , ma l'implicazione è significativa solo per le due coppie e : quindi è vera esiste con . Ora compare una sola volta: , quindi , polinomiale.
- La riduzione. , con e sostituiti dalle costanti delle configurazioni iniziale e accettante; i quantificatori si portano tutti in testa (le variabili sono tutte diverse). la QBF è vera. La costruzione è ripetitiva e usa solo contatori per gli indici delle variabili, quindi si fa in spazio logaritmico.
Le alternanze di quantificatori crescono con : per questo QSAT non sta in un livello fisso di PH (a meno di collassi).
Dove serve nelle tracce
F05 n. 7 · F07 n. 7 · G16 n. 6 · F13 n. 6 · L18 n. 1 · L18 n. 4 · FE23 n. 3 · SE23 n. 3
Classi
Problemi
Dove: dispensa cap. 17, p. 71; slide Lez. 9. La dispensa omette la prova; le slide della Lez. 9 la svolgono.
proposizioneComplemento di HAMILTON PATH: coNP-completo, -completo solo se
Il complemento di HAMILTON PATH è coNP-completo, quindi sta in . È anche -completo se e solo se ; QSAT si riduce a esso solo se PH collassa al primo livello.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Complemento di HAMILTON PATH: coNP-completo, -completo solo se
Intuizione
Se un problema di coNP fosse completo per il secondo livello, tutto il secondo livello cadrebbe in coNP: la gerarchia si fermerebbe al primo livello.
All'esame
Nell'esercizio 3 del cap. 17: il complemento di HAMILTON PATH si tratta come coNP-completo, e una riduzione da QSAT a esso farebbe collassare PH al primo livello.
Da scrivere all'esame
Il complemento di HAMILTON PATH è coNP-completo, non -completo (lo sarebbe solo se ): QSAT vi si riduce solo se e PH collassa al primo livello.
Dimostrazione
Idea: il complemento di HAMILTON PATH è coNP-completo; se fosse anche -completo, il secondo livello coinciderebbe con il primo, cioè .
- Il punto di partenza. HAMILTON PATH è NP-completo: il certificato è il cammino, verificabile in tempo polinomiale. Quindi il suo complemento sta in ed è coNP-completo (Proposizione B, cap. 14; riepilogo del cap. 22).
- Cosa seguirebbe dalla -completezza. Se il complemento di HAMILTON PATH fosse -completo, ogni problema di si ridurrebbe a un problema di coNP. coNP è chiusa rispetto alle riduzioni, quindi , cioè .
- Questo è un collasso. Complementando, . Inoltre (ogni livello contiene quelli sotto) , e complementando : dunque e PH collassa al primo livello (Corollario del Teorema 17.9).
- Il viceversa. Se , allora e ogni problema coNP-completo è anche -completo. Quindi il complemento di HAMILTON PATH è -completo esattamente se , che si crede falso.
- Conseguenza per l'esercizio 3 del cap. 17. HAMILTON PATH (complemento) → QSAT: sì, perché . QSAT → complemento di HAMILTON PATH: solo se ; allora , cioè PH collassa al primo livello.
Problemi
Dove: dispensa cap. 17, p. 74 (esercizio 3)
Capitolo 18 · Query su database
teoremaTeorema (complessità delle query ai database relazionali)
Per le query booleane in algebra relazionale la combined complexity e la expression complexity sono PSPACE-complete, la data complexity è L-completa. Per le query congiuntive (senza unioni né negazioni) combined ed expression complexity sono NP-complete, la data complexity è -completa.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema (complessità delle query ai database relazionali)
Intuizione
Se la query è fissa e varia solo il database, il problema diventa molto più facile.
Da scrivere all'esame
Per le query in algebra relazionale combined ed expression complexity sono PSPACE-complete e la data complexity è in ; per le query congiuntive NP-complete e .
Schema della dimostrazione
Idea: una query booleana in algebra relazionale equivale a una formula della logica del primo ordine (con ) valutata sul database. Se la query è parte dell'input, le sue alternanze di quantificatori codificano una QBF (PSPACE); se la query è fissa, ha un numero costante di variabili e si valuta con pochi contatori (spazio logaritmico). Le slide dicono che questi risultati non sono nel libro: qui c'è solo lo schema.
- Combined complexity in PSPACE. Si valuta la formula ricorsivamente, come l'algoritmo Truth per QSAT: per ogni quantificatore si provano uno alla volta gli elementi del database, riusando lo spazio. La profondità è al più la lunghezza della query e ogni livello ricorda un elemento: spazio polinomiale.
- Expression (e quindi combined) complexity PSPACE-difficile. Si fissa il database con dominio e una relazione ("è vero"). Una QBF diventa la query , dove si ottiene sostituendo ogni con . La query è vera sul database la QBF è vera: QSAT si riduce al problema con database fisso.
- Data complexity in . Con la query fissa, il numero di variabili è una costante. Si valutano i quantificatori con cicli annidati sugli elementi del database: contatori di bit ( = dimensione del database), e ogni atomo si controlla scorrendo l'input. Spazio . (La completezza dipende dal tipo di riduzioni usato: il contenuto da ricordare è il limite superiore .)
- Query congiuntive, combined complexity in NP. Una query congiuntiva è (congiunzione di atomi). Il certificato è un valore per ogni variabile; si verifica in tempo polinomiale che ogni atomo sia nel database.
- Query congiuntive, NP-difficile anche con database fisso. Da 3-COLORING: database fisso con la relazione = coppie di colori diversi tra . Dato un grafo, la query è su tutti gli archi : è vera il grafo è 3-colorabile. Quindi expression e combined complexity sono NP-complete.
- Query congiuntive, data complexity . Con la query fissa, la risposta è un grande "oppure" sulle scelte delle variabili, ciascuna un "e" di controlli sul database: un circuito di profondità costante e dimensione polinomiale, cioè .
Dove: dispensa cap. 18, p. 75; slide Lez. 9. Le slide precisano che questi risultati non sono nel libro di riferimento.
Capitolo 19 · Giochi
teoremaTeorema 19.3 (GEOGRAPHY è PSPACE-completo)
chiesto in 5 domandeDato un grafo, decidere se il primo giocatore ha una strategia vincente a GEOGRAPHY a partire dal nodo 1 è PSPACE-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 19.3 (GEOGRAPHY è PSPACE-completo)
Intuizione
Le mosse alternate dei due giocatori corrispondono ai quantificatori alternati di una QBF.
All'esame
Esercizio d'esame: GEOGRAPHY si riduce a QSAT; un unico che limiti le alternanze per tutte le istanze esisterebbe solo se PH e PSPACE collassassero a .
Da scrivere all'esame
SÌ: GEOGRAPHY è PSPACE-completo (Teorema 19.3), quindi si riduce a QSAT; un fisso di alternanze per tutte le istanze esisterebbe solo se PH e PSPACE collassassero a .
Schema della dimostrazione
Idea: GEOGRAPHY sta in PSPACE perché l'albero delle partite si esplora in profondità riusando lo spazio; è PSPACE-difficile perché una partita può imitare la valutazione di una formula quantificata (QSAT): il primo giocatore fa la parte di , il secondo quella di .
- Regole precise. C'è un grafo orientato ( = nodi, = archi) e si parte dal nodo 1. A turno ogni giocatore sceglie un nodo non ancora usato collegato da un arco all'ultimo nodo detto; chi non può muovere perde. Il divieto di ripetere (una città non si dice due volte) serve: grazie a esso una partita dura al più mosse ( = numero di nodi).
- . Procedura ricorsiva: il giocatore di turno vince se esiste una mossa verso un nodo libero tale che l'avversario, ripartendo da , non vince. La ricorsione è profonda al più e ogni livello ricorda solo il nodo scelto e il prossimo successore da provare: spazio , polinomiale. È la stessa forma "esiste una mossa tale che per ogni risposta…" di una QBF.
- Riduzione da QSAT: le variabili. Sia con in forma normale congiuntiva (aggiungendo variabili fittizie si ottiene che i quantificatori alternino e l'ultimo sia ). Per ogni variabile si mette un "rombo": dal nodo in alto si scende a sinistra ( vera) o a destra ( falsa) e ci si ricongiunge in basso. I rombi sono in catena; con nodi di raccordo si fa in modo che nel rombo scelga il primo giocatore se ha , il secondo se ha . Percorrere la catena = scegliere un'assegnazione nell'ordine dei quantificatori.
- Le clausole. Dal fondo dell'ultimo rombo il secondo giocatore va su un nodo-clausola ("questa clausola è falsa"); poi il primo va su un nodo-letterale di ("questo letterale è vero"). Il nodo-letterale ha un solo arco, verso il lato "vera" del rombo ; verso il lato "falsa".
- Chi vince. Ora tocca al secondo giocatore. Se il letterale è vero, quel nodo del rombo è già stato usato: lui non può muovere e perde. Se è falso, ci va, ma da lì l'unica uscita è il fondo del rombo, già usato: il primo non può muovere e perde. Quindi il primo vince il finale sse ogni clausola ha un letterale vero, cioè sse è vera con l'assegnazione scelta.
- Conclusione. Il primo giocatore ha una strategia vincente sse esiste un valore di tale che per ogni valore di … è vera, cioè sse è vera. Il grafo è lineare nella dimensione di e si costruisce in spazio logaritmico; QSAT è PSPACE-completo, quindi lo è anche GEOGRAPHY.
Classi
Problemi
Dove: dispensa cap. 19, p. 76; slide Lez. 9. Il numero 19.3 viene dalle slide; la dispensa lo chiama solo "Theorem".
teoremaTeorema 19.4 (GO è PSPACE-completo)
Data una scacchiera e una configurazione, decidere se un giocatore ha una strategia vincente a GO è PSPACE-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 19.4 (GO è PSPACE-completo)
Intuizione
Come per GEOGRAPHY, le strategie di gioco corrispondono all'alternanza dei quantificatori.
Da scrivere all'esame
GO generalizzato () è PSPACE-completo (Teorema 19.4): dire se il nero ha una strategia vincente equivale a valutare una QBF, quindi è in P solo se .
Schema della dimostrazione
Idea: come per GEOGRAPHY, una strategia vincente è un'alternanza "esiste una mia mossa tale che per ogni risposta…": si sta in PSPACE esplorando l'albero di gioco, e si è PSPACE-difficili perché sulla scacchiera si può disegnare una partita di GEOGRAPHY (Lichtenstein e Sipser, 1980).
- Il problema. Data una scacchiera e una configurazione, il giocatore che muove (il nero nelle slide, il primo giocatore nella dispensa: è lo stesso se muove il nero) ha una strategia vincente?
- Appartenenza a PSPACE. Si suppone, come nella formulazione del teorema, che la partita duri un numero di mosse polinomiale in . Allora si valuta l'albero di gioco in profondità come per GEOGRAPHY: ogni livello della ricorsione memorizza una scacchiera ( caselle) e la mossa in prova, e la profondità è polinomiale, quindi lo spazio è polinomiale. (Senza questo limite, con tutte le regole del ko le partite possono durare un numero esponenziale di mosse, e il problema diventa EXP-completo: per questo il limite serve.)
- Difficoltà: da quale problema si parte. Si riduce GEOGRAPHY ristretto a grafi planari (disegnabili senza incroci), con ogni nodo di grado al più 3: resta PSPACE-completo, perché i rombi della prova per GEOGRAPHY si possono disegnare in questa forma.
- Nodi e archi sulla scacchiera. Ogni arco diventa un "corridoio" di pietre e ogni nodo un incrocio di corridoi. Giocare all'ingresso di un corridoio minaccia di catturare un grande gruppo: l'avversario è costretto a rispondere in un punto preciso, altrimenti perde quel gruppo. Così le uniche mosse sensate sono quelle che percorrono un arco del grafo, e un nodo già usato corrisponde a un corridoio già chiuso.
- Chi vince. Alla fine c'è un gruppo enorme la cui cattura decide il punteggio: il giocatore che in GEOGRAPHY resta senza mosse perde quel gruppo e quindi la partita. Dunque il nero vince a GO sse il primo giocatore vince a GEOGRAPHY sul grafo di partenza.
- Conclusione. La configurazione ha dimensione polinomiale nel grafo e si costruisce in spazio logaritmico; insieme al punto 2, GO generalizzato è PSPACE-completo.
Classi
Dove: dispensa cap. 19, p. 77; slide Lez. 9. Il numero 19.4 viene dalle slide (che parlano del nero); la dispensa parla del primo giocatore.
Capitolo 20 · Crittografia e function problems
proposizioneFSAT è FNP-completo
chiesto in 2 domandeFSAT (trovare un'assegnazione che soddisfa una formula, oppure rispondere "no") è completo per FNP rispetto alle riduzioni tra function problems (coppie , calcolabili in spazio logaritmico).
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
FSAT è FNP-completo
Intuizione
È la versione "trova la soluzione" di SAT.
Da scrivere all'esame
FSAT è FNP-completo (ogni problema di FNP si riduce a FSAT con la costruzione di Cook-Levin), quindi se e solo se .
Schema della dimostrazione
Idea: FSAT sta in FNP perché controllare un'assegnazione è facile; ogni problema di FNP si traduce, con la costruzione di Cook-Levin, in una formula le cui assegnazioni che la soddisfano hanno "scritto dentro" una soluzione.
Richiamo: un problema sta in FNP se con una relazione (coppie istanza-certificato) polinomialmente bilanciata e decidibile in tempo polinomiale; chiede, data , un con , oppure "no".
- . La relazione contiene le coppie in cui è un'assegnazione delle variabili di che rende vera . È bilanciata ( non è più lunga di ) e si decide in tempo polinomiale valutando con i valori di .
- Un problema qualsiasi di FNP. Sia e sia una MdT deterministica che decide in tempo polinomiale; i certificati sono lunghi al più , con polinomio.
- La funzione (istanze). Data , si costruisce la formula della prova di Cook-Levin che descrive la tabella di computazione di sull'input : i simboli di sono fissati, quelli di sono lasciati come variabili libere . è soddisfacibile sse esiste un che accetta. Come in Cook-Levin, la tabella è regolare e si scrive in spazio logaritmico.
- "No" sse "no". non ha soluzione sse nessun è accettato da sse è insoddisfacibile, cioè sse FSAT risponde "no" su .
- La funzione (soluzioni). Se soddisfa , descrive una computazione accettante di su per un certo . legge da i valori delle variabili e li scrive: basta un contatore, quindi spazio logaritmico. Poiché accetta, : è una soluzione di .
Quindi e ogni problema di FNP si riduce a FSAT: FSAT è FNP-completo.
Classi
Dove: dispensa cap. 20, p. 80; appunti Lez. 10
proposizioneProposizione (FSAT e SAT)
per l'oraledimostrato nel corsoFSAT si risolve in tempo polinomiale se e solo se SAT si risolve in tempo polinomiale.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (FSAT e SAT)
Intuizione
Con un algoritmo per SAT si fissano le variabili una alla volta: si prova e si chiede se la formula resta soddisfacibile.
All'esame
Trovare una soluzione costa quanto decidere se esiste.
Da scrivere all'esame
Per la Proposizione su FSAT e SAT, FSAT si risolve in tempo polinomiale sse : con un decisore per SAT si fissano le variabili una alla volta.
Dimostrazione
Idea: chi sa trovare un'assegnazione sa anche dire se esiste; al contrario, con un decisore per SAT si fissano le variabili una alla volta, chiedendo ogni volta se la formula resta soddisfacibile.
- () FSAT polinomiale SAT polinomiale. Sia una MdT deterministica che risolve FSAT in tempo polinomiale. fa come , ma quando stampa un'assegnazione risponde "sì", e quando risponde "no" anche risponde "no". È corretto perché stampa un'assegnazione esattamente quando è soddisfacibile; il tempo è quello di .
- () L'algoritmo. Sia un algoritmo deterministico polinomiale per SAT e l'input. chiede ad se è soddisfacibile; se no risponde "no". Altrimenti, per : chiede ad se è soddisfacibile; se sì pone , altrimenti . Alla fine restituisce .
- Perché è corretto. Vale sempre questa proprietà: dopo il passo , la formula è soddisfacibile. All'inizio è vera perché ha detto "sì". Al passo : se con la formula resta soddisfacibile, la proprietà vale; altrimenti ogni assegnazione che soddisfa la formula del passo prima ha , e almeno una ne esiste, quindi con resta soddisfacibile.
- Fine. Dopo il passo tutte le variabili hanno un valore e la formula, ancora soddisfacibile, è semplicemente vera: soddisfa .
- Tempo. chiama volte, ogni volta su una formula non più lunga di (sostituire costanti non la allunga), e : il tempo totale è polinomiale.
Problemi
Dove: dispensa cap. 20, p. 81; appunti Lez. 10
teoremaTeorema
chiesto in 4 domandedimostrato nel corso se e solo se .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema
Intuizione
Se , FSAT è polinomiale, quindi anche SAT e allora ; se i function problems di NP e di P coincidono.
All'esame
Le risposte "solo se " equivalgono a "solo se ".
Da scrivere all'esame
sse (FSAT è FNP-completo e polinomiale sse ), quindi "solo se " equivale a "solo se ".
Dimostrazione
Idea: FSAT fa da ponte. Se , FSAT è polinomiale, quindi anche SAT e allora ; se , SAT è polinomiale, quindi anche FSAT e, essendo FSAT FNP-completo, ogni problema di FNP.
Richiamo: FP sono i function problem risolti in tempo polinomiale deterministico; FNP quelli associati a un (trovare un certificato per , oppure dire "no"). vale sempre.
- () . , quindi per ipotesi : si risolve in tempo polinomiale deterministico.
- Per la proposizione su FSAT e SAT, allora (basta ignorare l'assegnazione trovata e rispondere "sì").
- SAT è NP-completo (Cook): ogni si riduce a SAT, e una riduzione in spazio logaritmico richiede tempo polinomiale; quindi ogni sta in P. Dunque .
- () . La dispensa dice: se i problemi associati a P e a NP sono gli stessi (con la sua definizione di FP è immediato). Vediamolo in concreto: se allora , e per la proposizione FSAT si risolve in tempo polinomiale.
- Sia un problema qualsiasi di FNP. FSAT è FNP-completo, quindi ci sono e calcolabili in spazio logaritmico (dunque in tempo polinomiale) con: ha soluzione sse è soddisfacibile, e se soddisfa allora è una soluzione di .
- Algoritmo per : calcola , risolvi FSAT su ; se la risposta è "no" rispondi "no", altrimenti restituisci . Sono tre passi polinomiali in fila: . Quindi e, con , .
Dove: dispensa cap. 20, p. 81; appunti Lez. 10
Capitolo 21 · Oltre PSPACE
teoremaTeorema 20.1 (padding: )
chiesto in 5 domandedimostrato nel corsoSe , allora .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 20.1 (padding: )
Intuizione
Si allunga ogni input fino a lunghezza con simboli di riempimento: il tempo esponenziale diventa polinomiale nella nuova lunghezza, si usa e poi si torna indietro.
All'esame
Nella forma contronominale: se allora .
Da scrivere all'esame
Per il Teorema 20.1 (padding) ; quindi, per contronominale, se allora .
Dimostrazione
Idea (padding, cioè riempimento): si allunga ogni input con simboli di riempimento fino a lunghezza . Il budget di tempo esponenziale in diventa polinomiale nella nuova lunghezza; lì si usa , poi si toglie il riempimento.
- Partenza. Sia : una MdT nondeterministica decide con budget di tempo ( = lunghezza dell'input).
- Il linguaggio allungato. Con un simbolo nuovo ("semi-blank") si pone : ogni è seguita da tanti da arrivare a lunghezza esattamente .
- . Su un input , controlla che sia della forma giusta: una senza seguita solo da , di lunghezza totale (si calcola in binario e si conta: tempo polinomiale in ); se no rifiuta. Poi simula su leggendo come un blank. La simulazione richiede tempo : lineare nella lunghezza dell'input. Quindi è nondeterministica e polinomiale, e accetta sse .
- Si usa l'ipotesi. , quindi : c'è una MdT deterministica che decide in tempo per un fisso.
- Si torna a . La MdT deterministica , su input : (fase 1) scrive seguita dai , in tempo , dove è il costo polinomiale di gestire i contatori; (fase 2) esegue su , in tempo . Entrambe le fasi sono esponenziali.
- Correttezza. sse sse accetta sse accetta . Quindi .
Ogni di NEXP sta in EXP, cioè ; vale sempre. Dunque .
Dove serve nelle tracce
F01 n. 5 · F03 n. 7 · F08 n. 3 · G20v4 n. 4 · E26 n. 5
Dove: dispensa cap. 21, p. 83; appunti Lez. 10
Capitolo 22 · Riepilogo della complessità dei problemi
proposizioneProblemi NEXP-completi
chiesto in 7 domandeSUCCINCT CIRCUIT SAT e SCHÖNFINKEL-BERNAYS SAT (soddisfacibilità di formule del primo ordine senza simboli di funzione, senza uguaglianza e in forma normale prenessa) sono NEXP-completi.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Problemi NEXP-completi
Intuizione
Per Schönfinkel-Bernays bastano modelli piccoli, ma i controlli da fare sono in numero esponenziale.
All'esame
Un problema NEXP-completo non si riduce a un problema in P, perché .
Da scrivere all'esame
SÌ/NO: SUCCINCT CIRCUIT SAT e SCHÖNFINKEL-BERNAYS SAT sono NEXP-completi; non si riducono a un problema in P perché (gerarchia di tempo).
Schema della dimostrazione
Idea: SUCCINCT CIRCUIT SAT è CIRCUIT SAT su un circuito esponenziale descritto in poco spazio: è la versione "in grande" di Cook-Levin. Per SCHÖNFINKEL-BERNAYS SAT bastano modelli piccoli, ma i controlli sono esponenziali; la difficoltà si ottiene riducendo SUCCINCT CIRCUIT SAT.
- SUCCINCT CIRCUIT SAT. L'input è un circuito : dato in ingresso il numero binario ( bit) di una porta di un circuito enorme (fino a porte), restituisce il tipo della porta e i numeri delle porte che la alimentano. Domanda: è soddisfacibile?
- È in NEXP. Si calcola tutta la descrizione di interrogando per ogni ( volte), si indovina un input di e lo si valuta: tempo nondeterministico esponenziale.
- È NEXP-difficile. Sia deciso da nondeterministica in tempo . La prova di Cook-Levin (versione circuiti) dà, per , un circuito grande , soddisfacibile sse . Ma è regolarissimo: dal numero di una porta (riga, colonna, ruolo) i suoi predecessori si ottengono con semplici operazioni aritmetiche e guardando . Un circuito di dimensione polinomiale fa questi calcoli e si scrive in spazio logaritmico: è la riduzione.
- SCHÖNFINKEL-BERNAYS SAT: forma. , con senza quantificatori, senza funzioni e senza uguaglianza.
- Modelli piccoli. Si sostituiscono le con costanti nuove (skolemizzazione: la formula resta soddisfacibile o no). Se c'è un modello, restringerlo agli elementi nominati dalle costanti ne dà ancora uno, perché le formule solo restano vere nei sotto-modelli. Basta quindi cercare modelli con al più elementi (almeno uno).
- È in NEXP. Si indovina il modello: per ogni predicato di arietà (numero di argomenti) la sua tabella su tuple, al più ; poi si controlla su tutti i valori delle . Tutto in tempo esponenziale in .
- È NEXP-difficile (riduzione da SUCCINCT CIRCUIT SAT). Due costanti fanno da bit 0 e 1; un predicato vuol dire "la porta di numero di vale 1". La parte dice: per ogni numero di porta , per ogni e per ogni valore delle porte interne di , se è il calcolo corretto di su (si controlla porta per porta, senza quantificatori) e dice che è un AND con predecessori , allora ; lo stesso per OR e NOT, e la porta d'uscita vale 1. La formula è polinomiale in , ha prefisso e ha un modello sse ha un input che lo rende vero.
Dove serve nelle tracce
F01 n. 5 · F08 n. 3 · G20v3 n. 3 · G20v4 n. 4 · GE23 n. 3 · FE23 n. 1 · E26 n. 2
Classi
Problemi
SAT · CIRCUIT SAT · SCHÖNFINKEL-BERNAYS SAT · SUCCINCT CIRCUIT SAT
Dove: dispensa cap. 13, p. 51 (esercizio 2); dispensa cap. 22, p. 85; appunti Lez. 10. Gli appunti precisano il prefisso dei quantificatori () del frammento di Schönfinkel-Bernays, che la dispensa non indica.
proposizioneIndecidibilità del primo ordine
chiesto in 3 domandeLa validità delle formule del primo ordine sta in RE ma non in R; la soddisfacibilità del primo ordine sta in coRE ma non in R.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Indecidibilità del primo ordine
Intuizione
Si possono elencare tutte le dimostrazioni e prima o poi si trova quella di una formula valida, ma nessun algoritmo si ferma sempre; la soddisfacibilità è il complemento della validità ().
All'esame
Sono i problemi indecidibili in cima alla scala, sopra ogni classe di complessità del corso.
Da scrivere all'esame
La validità del primo ordine sta in RE ma non in , la soddisfacibilità in coRE ma non in : sono indecidibili, quindi sopra ogni classe di complessità del corso.
Schema della dimostrazione
Idea: le formule valide si possono elencare cercando le loro dimostrazioni (completezza di Gödel), quindi la validità è semi-decidibile; non è decidibile perché si potrebbe decidere l'arresto di una MdT (Church-Turing). La soddisfacibilità è il complemento della validità.
Richiamo: RE = problemi per cui esiste una MdT che si ferma con "sì" sulle istanze sì (sulle altre può non fermarsi); = problemi decidibili (la MdT si ferma sempre); coRE = complementi dei problemi in RE; .
- Validità . Per il teorema di completezza di Gödel, è valida (vera in ogni modello) sse ha una dimostrazione in un sistema di regole fissato. Le dimostrazioni sono stringhe finite: una MdT le elenca tutte, una dopo l'altra, e controlla meccanicamente se ciascuna è una dimostrazione corretta di . Se è valida, prima o poi la trova e si ferma con "sì"; se non lo è, cerca per sempre.
- Validità : la riduzione. Data una MdT e un input , si scrive una formula , dove sono assiomi che descrivono il calcolo di su (un predicato dice "al passo la MdT è nello stato , con la testina in posizione , e sul nastro c'è…", più gli assiomi che legano il passo al passo successivo secondo le transizioni di ) e dice "in qualche passo si raggiunge lo stato di arresto".
- Se si ferma su , in ogni modello degli assiomi le configurazioni seguono passo passo quelle vere, quindi anche quella di arresto (dopo un numero finito di passi): è valida.
- Se non si ferma, il modello "vero" (i passi sono i numeri naturali e le configurazioni sono quelle reali del calcolo) rende veri gli assiomi ma non : non è valida.
- Conclusione per la validità. si ferma su sse è valida. Il problema dell'arresto non è in , quindi neppure la validità.
- Soddisfacibilità. è soddisfacibile sse non è valida. Quindi la soddisfacibilità è il complemento della validità (a meno di tradurre in ): sta in coRE. Non sta in , perché è chiuso per complemento e la validità non è in . (Di conseguenza non sta neppure in RE: altrimenti starebbe in .)
Dove serve nelle tracce
Dove: dispensa cap. 22, p. 85; appunti Lez. 10. La dispensa lo riporta solo nel riepilogo del cap. 22. Il collegamento con il teorema di completezza di Gödel (validità in RE) e il nome "teorema di Church-Turing" (validità non in R) vengono dagli appunti della Lez. 10.
proposizione2-SAT è P-completo se e solo se
2-SAT sta in NL (ed è NL-completo), quindi in P. È P-completo se e solo se , che è una questione aperta: per esempio PRIMES si riduce a 2-SAT in spazio logaritmico solo se .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
2-SAT è P-completo se e solo se
Intuizione
Un problema di NL non può essere difficile per tutto P, a meno che P e NL coincidano.
All'esame
All'esame di 2-SAT si dice che sta in P (anzi in NL); le riduzioni da un problema qualsiasi di P a 2-SAT non sono garantite.
Da scrivere all'esame
Di 2-SAT si sa solo che è in P (anzi NL-completo); essere P-completo equivarrebbe a , questione aperta, quindi la riduzione da un problema di P non è garantita.
Dimostrazione
Idea: di 2-SAT si sa che sta in NL (spazio logaritmico nondeterministico) ed è NL-completo; dire che è anche P-completo equivale a dire , che è un problema aperto.
- Quello che si sa: (anzi ). Da una formula con clausole di 2 letterali si costruisce il grafo delle implicazioni: la clausola dà gli archi e . La formula è insoddisfacibile sse per qualche variabile c'è un cammino da a e uno da a (dispensa cap. 12: "ricerca di cicli in un grafo"). Cercare un cammino è REACHABILITY, che sta in NL; il complemento si gestisce con . Quindi .
- Cosa vorrebbe dire "P-completo". Ogni problema di P si ridurrebbe a 2-SAT con una riduzione in spazio logaritmico (quelle del corso).
- Conseguenza. Allora per ogni : si calcola la riduzione in spazio logaritmico e si risolve 2-SAT in NL; componendo si resta in NL (NL è chiuso per riduzioni in spazio logaritmico). Quindi , cioè ( vale sempre).
- Viceversa. Se , ogni problema di P sta in NL e si riduce a 2-SAT, che è NL-completo: 2-SAT sarebbe P-completo. Quindi "2-SAT P-completo" vale sse .
- All'esame. è una questione aperta, quindi la P-completezza di 2-SAT non si può usare. Per esempio non si può dire che PRIMES si riduce a 2-SAT in spazio logaritmico: si sa solo che .
All'esame di 2-SAT si dice solo che sta in P.
Dove: dispensa cap. 22, p. 84; dispensa cap. 14, p. 55 (esercizio 1)
proposizione e MAX-FLOW P-completo (riepilogo)
★ chiesto in 8 domandeIl riepilogo della dispensa elenca e MAX-FLOW P-completo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
e MAX-FLOW P-completo (riepilogo)
Intuizione
Sono fatti citati senza prova e usati negli esercizi sulle riduzioni.
All'esame
Per esempio: da MAX FLOW a 3-COLORING la riduzione esiste (, 3-COLORING NP-completo); da 3-COLORING a MAX FLOW solo se .
Da scrivere all'esame
e (è P-completo); 3-COLORING è NP-completo, quindi da MAX FLOW a 3-COLORING la riduzione esiste, al contrario solo se .
Schema della dimostrazione
Idea: sono due risultati famosi che il corso cita senza prova. (Agrawal, Kayal, Saxena, 2002) si basa su un'identità tra polinomi che vale solo per i primi; MAX-FLOW sta in P grazie ai cammini aumentanti ed è P-difficile perché un flusso può simulare un circuito.
- Dimensione dell'input. Il numero è scritto in binario, con circa cifre: provare tutti i divisori fino a richiede tempo esponenziale nella lunghezza. Serve un algoritmo polinomiale in .
- Identità chiave. Per primo con : è primo sse modulo , come polinomi in . Se è primo, i coefficienti binomiali intermedi sono multipli di e (Fermat); se è composto, qualche coefficiente non si annulla.
- Renderla veloce. Il polinomio ha coefficienti, troppi. Si controlla l'identità modulo , con piccolo (polinomiale in ), per pochi valori di ; con i quadrati ripetuti ogni controllo costa tempo polinomiale in . Prima si escludono le potenze perfette e i fattori .
- Correttezza. Un argomento algebrico (in campi finiti) mostra che, se tutti i controlli passano, è primo. In totale il tempo è polinomiale in .
MAX-FLOW è P-completo (versione di decisione: in una rete con capacità, sorgente , pozzo e un numero , esiste un flusso di valore ?)
- In P. Ford-Fulkerson con cammini aumentanti più corti (Edmonds-Karp): ogni aumento si trova con una visita in ampiezza e gli aumenti sono ( = nodi, = archi), indipendentemente dalle capacità: tempo polinomiale.
- P-difficile (Goldschlager, Shaw, Staples, 1982). Si riduce in spazio logaritmico il problema P-completo di valutare un circuito monotono (solo AND e OR). Ogni porta diventa un nodo, ogni filo un arco con capacità potenze di 2 scelte in base alla posizione della porta; un nodo di scarico assorbe il flusso in eccesso delle porte false. Così nel flusso massimo un filo è pieno sse la sua porta vale 1, e il circuito dà 1 sse il flusso massimo raggiunge una soglia calcolabile.
Dove serve nelle tracce
F01 n. 2 · F02 n. 1 · F03 n. 2 · G16 n. 1 · MZ22 n. 7 · GE23 n. 4 · E26 n. 5 · E26 n. 7
Classi
Dove: dispensa cap. 22, p. 84; dispensa cap. 13, p. 51 (esercizio 2); dispensa cap. 14, pp. 55–57 (esercizi)
Extra · Algoritmi probabilistici e quantistici (Lez. 6, solo slide)
teoremaTeorema 11.3 ()
chiesto in 3 domandedimostrato nel corso, dove PP è la classe dei problemi decisi in tempo polinomiale da MdT che accettano a maggioranza dei run.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema 11.3 ()
Intuizione
Si trasforma la macchina nondeterministica per in una che accetta a maggioranza e risponde come lei.
All'esame
Si pensa che il contrario non valga.
Da scrivere all'esame
(Teorema 11.3): aggiungendo metà run che accettano sempre, un solo run accettante basta per la maggioranza; il contrario si pensa che non valga.
Dimostrazione
Cosa vuol dire: una MdT nondeterministica accetta a maggioranza se più della metà dei suoi run (computazioni) su termina con "yes"; con i run equiprobabili, "yes" è la risposta più probabile scegliendone uno a caso. PP è la classe dei problemi decisi così in tempo polinomiale.
Idea: si affianca alla macchina per un blocco di run che dicono tutti "yes" e sono esattamente metà: così basta un solo run accettante della macchina originale per superare la metà.
- Partenza. Sia , decisa da una MdT standardizzata in tempo , con polinomio. "Standardizzata" vuol dire che ogni run fa esattamente scelte binarie: i run sono esattamente . sse almeno un run di accetta.
- La nuova macchina . Un nuovo stato iniziale fa una scelta tra due rami: (a) eseguire ; (b) fare scelte binarie a vuoto e terminare sempre con "yes".
- Il conteggio. Ciascun ramo produce run, quindi ha run. Accettare a maggioranza vuol dire avere più di run "yes", cioè almeno .
- Perché risponde come . Il ramo (b) dà esattamente "yes": precisamente la metà, non di più. La maggioranza c'è quindi sse il ramo (a) aggiunge almeno un "yes", cioè sse almeno un run di accetta , cioè sse .
- Tempo. fa una scelta in più di : tempo , polinomiale. Quindi .
Poiché era un qualsiasi problema di NP, .
Dove serve nelle tracce
Classi
Dove: slide Lez. 6. Solo nelle slide della Lez. 6 (algoritmi probabilistici), non nella dispensa. PP non è tra le classi della mappa: si indica la classe collegata.
teoremaTeorema ()
chiesto in 7 domandedimostrato nel corso.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema ()
Intuizione
Una macchina deterministica esegue uno alla volta tutti i run, riusando lo spazio, e conta i "yes" e i "no" con contatori di bit.
All'esame
Insieme agli altri risultati dà .
Da scrivere all'esame
: una MdT deterministica prova tutti i run uno alla volta riusando lo spazio e conta i "yes" con contatori binari di cifre.
Dimostrazione
Cosa vuol dire: se una MdT nondeterministica polinomiale accetta a maggioranza, cioè con più della metà dei run che terminano in "yes", esattamente quando .
Idea: invece di scegliere un run a caso, una macchina deterministica li prova tutti, uno dopo l'altro, riusando lo stesso spazio, e conta i "yes" e i "no". I contatori sono piccoli perché in binario anche un numero esponenziale occupa poche cifre.
- Partenza. Sia : una MdT standardizzata accetta a maggioranza in tempo ( = lunghezza dell'input). Ogni run fa scelte binarie, quindi i run sono .
- La macchina . è deterministica ed esegue tutti i run di uno alla volta. Un run è individuato dalla sequenza delle sue scelte: la tiene sul nastro e la fa avanzare come un contatore binario per passare al run successivo.
- Uso del nastro. Il nastro contiene: l'input ; il contatore dei "yes"; il contatore dei "no"; la sequenza di scelte del run corrente; lo spazio di lavoro del run.
- Contatori: . I conteggi arrivano al più a , che in binario richiede cifre.
- Scelte: . Sono simboli.
- Lavoro: . Un run fa al più passi, quindi tocca al più celle. Finito un run, aggiorna il contatore giusto e cancella lo spazio di lavoro, che viene riusato dal run successivo.
- Risposta. Esauriti i run, accetta sse i "yes" sono più dei "no": è proprio l'accettazione a maggioranza di , quindi decide .
In totale usa spazio (il tempo è esponenziale, ma non importa): . Quindi .
Dove serve nelle tracce
F05 n. 5 · F12 n. 3 · F12 n. 7 · G17 n. 5 · G20v3 n. 6 · GE23 n. 2 · LU24 n. 1
Classi
Dove: slide Lez. 6. Solo nelle slide della Lez. 6, non nella dispensa.
proposizioneProposizioni e
chiesto in 3 domandedimostrato nel corso e .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizioni e
Intuizione
Una MdT deterministica ha un solo run, quindi la risposta giusta ha il 100% dei voti; la maggioranza qualificata di BPP è in particolare una maggioranza semplice.
Da scrivere all'esame
: un run deterministico è il 100% delle risposte, e la maggioranza qualificata () di BPP è in particolare una maggioranza semplice.
Dimostrazione
Cosa vuol dire: (errore limitato) se una MdT nondeterministica polinomiale standardizzata, quando , ha almeno dei run che accettano, e quando almeno dei run che rifiutano: un run scelto a caso sbaglia con probabilità al più , ben lontana da . In PP basta invece la maggioranza semplice (più della metà dei run).
Idea: una macchina deterministica ha un solo run, quindi la risposta giusta ha il 100% dei voti; e una maggioranza di è, in particolare, una maggioranza semplice.
- . Sia , decisa da una MdT deterministica in tempo polinomiale. è un caso particolare di MdT nondeterministica, che genera sempre un solo run.
- Se , l'unico run accetta: accetta il 100% dei run, che è almeno . Se , l'unico run rifiuta: rifiuta il 100% dei run. Quindi soddisfa la definizione di BPP e .
- . Sia con la sua macchina . Si usa la stessa come macchina per PP.
- Se , almeno dei run accettano, e : accetta a maggioranza.
- Se , almeno dei run rifiutano, quindi accettano al più dei run, meno della metà: non accetta a maggioranza.
- Quindi sse accetta a maggioranza, nello stesso tempo polinomiale: .
Classi
Dove: slide Lez. 6. Solo nelle slide della Lez. 6, non nella dispensa. BPP e PP non sono tra le classi della mappa completa: stanno nella mappa della scheda Probabilistiche.
proposizioneRiduzione dell'errore in BPP
chiesto in 6 domandedimostrato nel corsoIn BPP la soglia è convenzionale: con ripetizioni e voto di maggioranza l'errore scende sotto qualunque , con che dipende solo da (per esempio, partendo da , ). In PP invece le ripetizioni necessarie possono essere esponenziali.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Riduzione dell'errore in BPP
Intuizione
Con una maggioranza "chiara" ogni ripetizione rende sempre più improbabile che vinca la risposta sbagliata.
All'esame
Distingue BPP (errore riducibile con poche ripetizioni) da PP (nessun metodo noto in tempo polinomiale).
Da scrivere all'esame
In BPP ripetizioni con voto di maggioranza portano l'errore sotto , con costante; in PP il vantaggio può essere esponenzialmente piccolo e le ripetizioni esponenziali.
Dimostrazione
Cosa vuol dire: in BPP (errore limitato) ogni esecuzione dà la risposta giusta con probabilità almeno , con fisso (il "vantaggio"; con la soglia , ). In PP (maggioranza semplice) la risposta giusta è solo più probabile di quella sbagliata, e il vantaggio può essere piccolissimo. (Le slide chiamano anche il vantaggio; qui lo chiamo per non confonderlo con l'errore voluto .)
Idea: si ripete l'algoritmo e si prende la risposta più frequente. Se il vantaggio è fisso, l'errore della maggioranza scende in modo esponenziale col numero di ripetizioni, quindi bastano poche ripetizioni (un numero costante); se è esponenzialmente piccolo, come può accadere in PP, ne servono un numero esponenziale.
- La nuova macchina. esegue volte, con scelte indipendenti, e risponde come la maggioranza delle risposte. Il numero dispari evita i pareggi. sbaglia solo se almeno esecuzioni su sbagliano.
- Il limite di Chernoff (slide). Se ogni esecuzione è giusta con probabilità , la probabilità che la maggioranza di esecuzioni sia sbagliata è al più . Perché scende: in media le risposte giuste superano la metà di circa , che cresce come , mentre le oscillazioni casuali crescono solo come ; Chernoff dice che la probabilità di uno scarto così grande cala in modo esponenziale.
- Il conto partendo da . , quindi l'errore è al più . Vogliamo : prendendo il logaritmo, , cioè . Basta . Esempio: per , , quindi e 75 ripetizioni.
- La soglia è convenzionale. Partendo da un qualsiasi , per arrivare a errore serve , cioè . Qualunque soglia con dà la stessa classe BPP.
- Costo. dipende solo da e da , non dall'input: il tempo viene moltiplicato per la costante e resta polinomiale.
- Perché in PP non funziona. In PP la maggioranza può essere minima, per esempio run "yes" contro run "no": la probabilità di risposta giusta è , cioè , che dipende da e diventa piccolissimo. Il limite richiede : un numero esponenziale di ripetizioni, quindi tempo esponenziale. Non si conosce un altro modo polinomiale per ridurre l'errore in PP.
Dove: slide Lez. 6; appunti Lez. 11. Solo nelle slide della Lez. 6, non nella dispensa.
teoremaTeoremi
★ chiesto in 8 domande e ; di conseguenza e .
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teoremi
Intuizione
Le macchine quantistiche generalizzano le distribuzioni di probabilità di BPP, e la condizione di accettazione di PP è ancora più debole.
All'esame
Simulare un algoritmo quantistico richiede al più spazio polinomiale; si pensa che .
Da scrivere all'esame
: un algoritmo quantistico si simula in spazio polinomiale, quindi i problemi PSPACE-completi stanno in BQP solo se .
Schema della dimostrazione
Cosa vuol dire: se una macchina di Turing quantistica (QTM) polinomiale, misurata alla fine, dà "yes" con probabilità quando e quando : errore limitato come in BPP, ma le probabilità dei run non sono uguali, vengono dalle ampiezze delle transizioni. In PP basta che il "yes" abbia più della metà dei run (maggioranza semplice).
Idea: una QTM può lanciare monete eque, quindi imita una macchina di BPP; al contrario la probabilità di accettare di una QTM si scrive come differenza tra due conteggi di cammini, che una macchina di PP sa confrontare con .
- . Sia la macchina standardizzata di BPP per : ogni run fa scelte binarie e i run sono equiprobabili. La QTM esegue ; a ogni scelta mette un qubit nello stato , cioè ampiezza per ciascun valore, che alla misura dà 0 o 1 con probabilità ; le altre transizioni hanno ampiezza 1. ( deve essere reversibile: basta tenere sul nastro le scelte fatte, con costo polinomiale.)
- Le scelte restano scritte, quindi run diversi finiscono in configurazioni diverse e non si cancellano a vicenda: ogni configurazione finale ha probabilità , come un run di . Dunque è la frazione di run accettanti: se , se . Quindi .
- (Adleman, DeMarrais, Huang). Sia la QTM per , precisa (tutti i cammini lunghi uguale). Si può supporre (risultato noto) che usi solo le ampiezze e che ogni cammino abbia lo stesso numero di passi con ampiezza . Allora ogni cammino ha ampiezza , e l'ampiezza di una configurazione finale è la somma su tutti i cammini che arrivano in : , con e numero di cammini con segno e con segno .
- , e = (coppie di cammini verso con segni uguali) (coppie con segni opposti).
- La MdT nondeterministica indovina due cammini di (polinomiali) e li calcola: se finiscono nella stessa configurazione accettante, accetta se i segni sono uguali e rifiuta se sono opposti; altrimenti fa un'ultima scelta e accetta su un ramo e rifiuta sull'altro (contributo nullo). Così (run "yes") − (run "no") è proporzionale a .
- Aggiungendo un blocco di run con risposta fissata (come nella prova di ) si sposta la soglia: accetta a maggioranza sse . Con la promessa di BQP ( oppure ) questo succede sse . Quindi .
- Corollari. ; .
Dove serve nelle tracce
F01 n. 5 · F12 n. 3 · G20v3 n. 6 · LU22 n. 6 · GE23 n. 2 · SE23 n. 4 · ND n. 2 · SP n. 4
Dove: slide Lez. 6; appunti Lez. 11. Solo nelle slide della Lez. 6, non nella dispensa. BQP non è tra le classi della mappa completa: sta nella mappa della scheda Quantistiche.
teoremaTeorema
per l'oraledimostrato nel corso: , e per il teorema di gerarchia del tempo.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Teorema
Intuizione
La catena delle inclusioni dimostrate arriva a EXP, che sta strettamente dentro 2-EXP (tempo doppiamente esponenziale).
All'esame
I problemi 2-EXP-completi non si risolvono in tempo polinomiale su un computer quantistico: è un risultato certo, non una congettura.
Da scrivere all'esame
, quindi : un problema 2-EXP-completo (per esempio il ragionamento su ontologie OWL2) non si risolve in tempo polinomiale nemmeno con un calcolatore quantistico.
Dimostrazione
Idea: non serve nessuna proprietà speciale del calcolo quantistico. Basta mettere in fila inclusioni già dimostrate e una separazione che viene dalla gerarchia del tempo: BQP sta dentro EXP, ed EXP è strettamente più piccola di 2-EXP.
- . Un algoritmo quantistico con errore limitato si simula in spazio polinomiale su una macchina classica (teoremi e della Lezione 6).
- . Una macchina con budget di spazio polinomiale ha al più configurazioni diverse; se si ferma, lo fa entro quel numero di passi, che è esponenziale (teorema "spazio dato il tempo").
- . Ogni problema di EXP sta in per qualche , e per grande, quindi . Per la gerarchia del tempo con budget (funzione propria, ): , e è ancora doppiamente esponenziale, quindi sta in 2-EXP. C'è dunque un problema di 2-EXP che non sta in e quindi nemmeno in EXP.
- Conclusione. Mettendo insieme: . Se fosse , avremmo , contro il punto 3; quindi .
- Conseguenza (slide Lez. 6). Se un problema 2-EXP-completo stesse in BQP, ogni problema di 2-EXP si ridurrebbe a lui e, poiché BQP è chiusa rispetto alle riduzioni, staremmo in , impossibile. Quindi i problemi 2-EXP-completi, come il ragionamento su ontologie OWL2, restano difficili anche per un calcolatore quantistico: è un risultato dimostrato, non una congettura.
Attenzione: per NP e BQP non si sa nulla di simile; che NP non stia in BQP è solo una congettura.
Dove: slide Lez. 6. Solo nelle slide della Lez. 6, non nella dispensa. BQP e 2-EXP non sono tra le classi della mappa completa: stanno nella mappa della scheda Quantistiche.
proposizioneProposizione (algoritmo di Grover sui problemi in NP)
chiesto in 4 domandedimostrato nel corsoOgni problema in NP si risolve con un algoritmo quantistico con errore limitato in tempo , cioè circa la radice quadrata del tempo della ricerca esaustiva.
Idea, frase per l'esame e dimostrazione +Chiudi approfondimento −
Proposizione (algoritmo di Grover sui problemi in NP)
Intuizione
Grover cerca in una lista non ordinata di elementi in circa passi; si applica alla ricerca del certificato.
All'esame
L'accelerazione è solo quadratica: non mette i problemi NP-completi in tempo polinomiale.
Da scrivere all'esame
Con Grover ogni problema in NP si risolve quantisticamente con errore limitato in tempo : accelerazione solo quadratica, il tempo resta esponenziale.
Dimostrazione
Cosa vuol dire: un algoritmo quantistico con errore limitato dà la risposta giusta con probabilità almeno (come in BQP); ripetendolo poche volte l'errore scende sotto qualunque soglia fissata.
Idea: un problema in NP è la ricerca di un certificato in un insieme enorme di candidati; l'algoritmo di Grover cerca in un insieme non ordinato di elementi con circa valutazioni, invece di . Il tempo della ricerca esaustiva viene quindi messo sotto radice quadrata.
- Il problema come ricerca. Sia : sse esiste un certificato , lungo al più su un alfabeto di simboli, con , verificabile in tempo polinomiale . L'insieme dei candidati ha circa elementi; si pone sse .
- Forza bruta. Provare tutti i candidati costa .
- Grover. Trova un con , se esiste, con errore limitato e valutazioni di : tempo .
- Risposta ed errore. Si controlla classicamente sul restituito: se si risponde "sì" (mai sbagliato); altrimenti "no". Se la risposta "no" è sempre giusta; si sbaglia solo se e Grover manca il certificato. Ripetendo volte l'errore scende sotto ; è una costante che dipende solo da .
- Tempo totale. . Il fattore polinomiale si assorbe prendendo una base un po' più grande : per grande . Quindi il tempo è .
- Esempio delle slide: KNAPSACK. = sottoinsiemi degli oggetti, ; sse il peso totale di è e il valore totale , calcolabile in . Costo: .
Il tempo resta esponenziale: l'esponente si dimezza (accelerazione quadratica), quindi si risolvono istanze circa doppie, ma i problemi NP-completi non diventano polinomiali.
Dove serve nelle tracce
F03 n. 6 · G20v2 n. 6 · G20v3 n. 5 · SP n. 4
Classi
Problemi
Dove: slide Lez. 6. Solo nelle slide della Lez. 6 (prova accennata per KNAPSACK), non nella dispensa.